ADsP 데이터분석 준전문가 37회 필기 기출문제 50문항입니다. 먼저 아래 출제 분석으로 회차의 난이도와 단원 구성을 확인한 뒤, 문제마다 정답 · 해설 보기를 눌러 정답과 해설을 확인하세요.
37회 출제 분석
이 회차는 아직 회원 풀이 기록이 충분하지 않아 정답률을 표시하지 않습니다. 아래는 과목 구성과 문항 정보입니다.
많이 나온 단원은 데이터 이해: 데이터와 정보 6문항, 빅데이터의 가치와 위기 2문항 / 데이터 분석 기획: 분석 방법론 3문항, 마스터 플랜·거버넌스 3문항 / 데이터 분석: 정형 데이터 마이닝 12문항, 통계 분석 11문항입니다.
과목
문항
단원 분포
데이터 이해
10
데이터와 정보 6 · 빅데이터의 가치와 위기 2 · 데이터 사이언스·인재 1 · 데이터베이스 활용 1
데이터 분석 기획
10
분석 방법론 3 · 마스터 플랜·거버넌스 3 · 분석 과제 발굴 2 · 분석 기획 기본 2
데이터 분석
30
정형 데이터 마이닝 12 · 통계 분석 11 · 시계열·차원 축소 4 · R·데이터 전처리 3
회원 정답률은 패스뱅크 회원이 문제풀이·모의고사에서 실제로 푼 기록을 집계한 값입니다. 문제 하나는 풀이 10건, 과목·단원·회차 묶음은 50건 이상일 때만 표시합니다. 단원은 문제 문장의 핵심 용어로 패스뱅크가 자동 분류한 것이라 공식 출제 기준표의 단원과 다를 수 있습니다.
데이터 이해
문제 1
단원 데이터 사이언스·인재
다음 중 데이터 사이언티스트의 역량에 대한 설명이 아닌 것은?
①설득력 있는 전달을 위한 스토리텔링과 시각화를 할 수 있어야 한다.
②창의적 사고와 호기심, 논리적 비판력을 갖고 통찰력 있는 분석을 한다.
③빅데이터에 대한 이론적 지식 및 분석 기술에 대한 숙련이 필요하다.
④알고리즘에 의해 부당하게 피해를 입은 사람을 구제한다.
정답 · 해설 보기
정답 ④
데이터 사이언티스트의 역량은 하드 스킬(이론적 지식, 분석 기술 숙련)과 소프트 스킬(통찰력 있는 분석, 설득력 있는 전달, 다분야 간 협력)로 나뉩니다. 알고리즘에 의해 부당하게 피해를 입은 사람을 구제하는 일은 알고리즈미스트의 역할이므로 데이터 사이언티스트의 역량에 대한 설명이 아닙니다. 시험 포인트: 데이터 사이언티스트 = 하드 스킬 + 소프트 스킬, 알고리즘 피해 구제 = 알고리즈미스트
문제 2
단원 데이터와 정보
경영정보시스템의 하나로 다양한 비즈니스 분야에서 생산, 구매, 재고, 주문, 공급자와의 거래, 고객 서비스 제공 등 주요 프로세스 관리를 돕는 여러 모듈로 구성된 통합 애플리케이션 소프트웨어 패키지를 무엇이라고 하는가?
①CRM
②ERP
③SCM
④KMS
정답 · 해설 보기
정답 ②
ERP는 제조업을 포함한 다양한 비즈니스 분야에서 생산, 구매, 재고, 주문, 공급자와의 거래, 고객 서비스 제공 등 주요 프로세스 관리를 돕는 여러 모듈로 구성된 통합 애플리케이션 소프트웨어 패키지입니다. CRM은 고객 관계 관리, SCM은 공급망 관리, KMS는 조직 내 지식을 체계적으로 관리하는 시스템입니다. 시험 포인트: ERP = 전사적 자원 관리, CRM = 고객 관계 관리, SCM = 공급망 관리, KMS = 지식 관리
문제 3
단원 데이터베이스 활용
다음 데이터베이스의 특징에 대한 설명 중 옳지 않은 것은 무엇인가?
①통합된 데이터로 동일한 내용의 데이터가 중복되어 저장된다.
②저장된 데이터로 컴퓨터가 접근할 수 있는 저장매체에 저장된다.
③공용 데이터로 여러 사용자에게 서로 다른 목적으로 데이터가 공동 이용된다.
④변화되는 데이터로 항상 변화하면서도 항상 현재의 정확한 데이터를 유지해야 한다.
정답 · 해설 보기
정답 ①
데이터베이스의 특징은 통합 데이터, 저장 데이터, 공용 데이터, 변화하는 데이터입니다. 통합 데이터는 같은 내용의 데이터가 중복되지 않도록 모아 둔다는 뜻이므로 중복되어 저장된다는 설명이 틀렸습니다. 나머지는 저장 데이터, 공용 데이터, 변화하는 데이터를 옳게 설명했습니다. 시험 포인트: 데이터베이스 특징 = 통합(중복 최소화)·저장·공용·변화하는 데이터
문제 4
단원 데이터와 정보
다음은 DIKW 구조와 예시가 올바르게 짝지어진 것은? (가) A 마트는 500원, B마트는 400원에 볼펜을 판매한다. (나) B 마트의 다른 상품도 A 마트보다 저렴할 것이다. (다) B 마트는 볼펜 가격이 싸다. (라) 상대적으로 저렴한 B 마트에서 볼펜을 사야겠다.
①(가) 데이터 (나) 정보 (다) 지식 (라) 지혜
②(가) 정보 (나) 데이터 (다) 지혜 (라) 지식
③(가) 데이터 (나) 지혜 (다) 정보 (라) 지식
④(가) 데이터 (나) 지혜 (다) 지식 (라) 정보
정답 · 해설 보기
정답 ③
(가) 두 마트의 볼펜 가격은 가공하기 전의 사실이므로 데이터입니다. 가격을 비교해 B 마트가 싸다는 의미를 끌어낸 (다)는 정보이고, 이 정보를 바탕으로 상대적으로 저렴한 B 마트에서 사야겠다고 판단한 (라)는 지식입니다. 근본 원리에 대한 이해를 바탕으로 B 마트의 다른 상품도 저렴할 것이라는 새로운 아이디어를 낸 (나)는 지혜입니다. 지식과 지혜를 서로 바꿔 놓는 함정이 자주 나옵니다. 시험 포인트: 데이터(가격 사실) → 정보(B가 싸다) → 지식(B에서 사야겠다) → 지혜(B의 다른 상품도 쌀 것이다)
문제 5
단원 빅데이터의 가치와 위기
다음 중 전략적 인사이트를 주는 가치 기반 분석을 위해 고려할 사항이 아닌 것은?
①비즈니스 성과
②인구통계학적 변화
③경제사회 트렌드
④고객 니즈의 변화
정답 · 해설 보기
정답 ①
전략적 인사이트를 주는 가치 기반 분석을 하려면 사업과 이에 영향을 미치는 트렌드에 대한 큰 그림을 그려야 합니다. 이를 위해 인구통계학적 변화, 경제사회 트렌드, 고객 니즈의 변화를 고려합니다. 비즈니스 성과는 이렇게 고려해야 할 환경 요인에 해당하지 않습니다. 시험 포인트: 가치 기반 분석 고려 = 인구통계학적 변화·경제사회 트렌드·고객 니즈 변화(큰 그림)
문제 6
단원 빅데이터의 가치와 위기
빅데이터가 가치창출 측면에서 기업, 정부, 개인에 미치는 영향으로 옳지 않은 것은?
①기업은 빅데이터를 활용하여 시장변동을 예측하여 비즈니스 모델을 혁신하고 신사업을 발굴할 수 있다.
②정부는 기상, 인구이동, 각종 통계, 법체 데이터 등을 수집해 사회 변화를 추정할 수 있다.
③운용 효율성이 증가하면 산업 전체의 생산성이 향상, 국가 전체로서는 GDP가 올라가는 효과가 있다.
④개인은 아직 데이터를 활용할 수 없다.
정답 · 해설 보기
정답 ④
빅데이터는 기업뿐 아니라 정부와 개인에게도 가치를 만듭니다. 기업은 시장 변동을 예측해 비즈니스 모델을 혁신하고, 정부는 각종 통계와 데이터를 수집해 사회 변화를 추정하며, 개인은 맞춤형 서비스를 저렴한 비용으로 이용하고 필요한 정보를 적시에 얻을 수 있습니다. 그래서 개인은 아직 데이터를 활용할 수 없다는 설명이 틀렸습니다. 시험 포인트: 빅데이터 가치창출 = 기업(비즈니스 모델 혁신)·정부(사회 변화 추정)·개인(맞춤형 서비스)
문제 7
단원 데이터와 정보
다음 데이터에 대한 설명 중 틀린 것은?
①비정형 데이터는 데이터 내부에 메타 데이터를 갖고 있고 파일 형태로 저장된다.
②정형 데이터는 행과 열에 의해 데이터의 속성이 구별되는 스프레드 시트 형태이다.
③반정형 데이터는 Parsing을 통해 구조를 파악할 수 있다.
④HTML, XML, JSON은 반정형 데이터이다.
정답 · 해설 보기
정답 ①
비정형 데이터는 형태나 구조가 정형화되지 않은 데이터이며 잠재 가치가 가장 높습니다. 데이터 내부에 메타 데이터를 갖고 있는 것은 반정형 데이터입니다. 정형 데이터는 행과 열로 속성이 구별되는 스프레드시트 형태이고, HTML, XML, JSON은 반정형 데이터입니다. 시험 포인트: 정형 = 행·열 표, 반정형 = 메타 정보 포함(HTML·XML·JSON), 비정형 = 구조 없음
문제 8
단원 데이터와 정보
다음 데이터 저장소에 대한 설명 중 옳은 것은?
①데이터 마트는 특정 조직이나 부서의 사람들과 같이 제한된 사용자 그룹에게 서비스가 제공된다.
②기업의 원천(Source) 데이터베이스는 데이터 마트(Data Mart)이다.
③데이터웨어하우스는 데이터 저장소로 저장만 가능하며, 데이터를 검색할 수 없다.
④데이터웨어하우스는 전사적 차원보다는 특정 조직의 업무분야에 초점을 맞춘다.
정답 · 해설 보기
정답 ①
데이터 마트는 전사적으로 구축된 데이터웨어하우스로부터 특정 주제나 부서 중심으로 구축한 소규모 단일 주제의 데이터웨어하우스로, 특정 조직이나 팀처럼 제한된 사용자 그룹에게 서비스가 제공됩니다. 원천 데이터베이스는 데이터 마트가 아니며, 데이터웨어하우스는 검색과 분석이 가능하고 전사적 차원에 초점을 맞춥니다. 시험 포인트: 데이터웨어하우스 = 전사적 통합·분석용, 데이터 마트 = 특정 부서·주제용 소규모 DW
문제 41
단원 데이터와 정보
DIKW 계층구조에서 데이터의 가공 및 처리와 데이터 간 연관관계 속에서 의미가 도출된 것을 무엇이라 하는가?
정답 · 해설 보기
정답 정보 (단답형)
DIKW 피라미드는 데이터(Data), 정보(Information), 지식(Knowledge), 지혜(Wisdom) 순으로 올라갑니다. 데이터를 가공·처리하고 데이터 간 연관관계 속에서 의미를 도출한 단계가 정보입니다. 정보에서 패턴을 찾아 체계화하면 지식, 지식에 창의적 아이디어가 더해지면 지혜가 됩니다. 시험 포인트: DIKW = 데이터(객관적 사실) → 정보(가공·의미 도출) → 지식(패턴·체계화) → 지혜(창의적 아이디어)
문제 42
단원 데이터와 정보
빅데이터 활용 기본 테크닉 중 다음이 설명하는 것은 무엇인가? 이것은 어떤 변인들 간에 주목할 만한 상관관계가 있는지를 찾아내는 방법으로, 상관 관계가 높은 상품을 함께 진열하거나 시스템 로그 데이터를 분석해 침입자나 유해 행위자 색출이 가능하며, 우유 구매자가 기저귀를 더 많이 구매하는지 등을 분석할 때 사용한다.
정답 · 해설 보기
정답 연관규칙학습 (단답형)
어떤 변인들 간에 주목할 만한 상관관계가 있는지 찾아내는 기법은 연관규칙학습입니다. 상품 진열, 로그 분석을 통한 침입자 색출, 우유 구매자와 기저귀 구매 같은 사례가 대표 예입니다. 유형 분석은 새로운 데이터가 어떤 집단에 속하는지 분류하는 기법, 유전 알고리즘은 진화를 모방해 최적해를 찾는 기법, 감정 분석은 텍스트에서 긍정·부정 감정을 파악하는 기법입니다. 시험 포인트: 연관규칙학습 = 변인 간 상관관계 탐색(장바구니 분석, 우유와 기저귀), 유형 분석 = 집단 분류, 감정 분석 = 긍·부정 파악
데이터 분석 기획
문제 9
단원 분석 과제 발굴
다음 분석과제 발굴의 접근방식에 대한 설명 중 옳지 않은 것은?
①디자인 싱킹은 중요한 의사결정시 상향식과 하향식을 반복적으로 사용하는 방법이다.
②분석해야 하는 대상이 확실할 경우 상향식 접근 방식을 사용한다.
③데이터를 활용하여 생각하지 못했던 인사이트를 도출하고 시행착오를 통해 개선해 가는 상향식접근법의 유용성이 점차 증가하고 있는 추세이다.
④분석과제 발굴의 상향식과 하향식접근법은 실제 분석과정에서 혼용되어 활용되는 경우가 많다
정답 · 해설 보기
정답 ②
하향식 접근은 문제가 확실할 때(분석 대상이 명확할 때) 사용하고, 상향식 접근은 문제의 정의 자체가 어려울 때 사용합니다. 그래서 분석해야 하는 대상이 확실할 때 상향식을 쓴다는 설명이 틀렸습니다. 디자인 씽킹은 중요한 의사결정에서 상향식과 하향식을 반복적으로 사용합니다. 시험 포인트: 하향식 = 문제가 확실할 때, 상향식 = 문제 정의가 어려울 때, 디자인 씽킹 = 두 방식 반복
문제 10
단원 분석 방법론
다음 중 빅데이터 분석 방법론의 분석 기획 단계에서 수행하는 주요 태스크가 아닌 것은 무엇인가?
①필요 데이터 정의
②비즈니스 이해 및 프로젝트 범위 설정
③프로젝트 정의 및 수행 계획 수립
④프로젝트 위험 계획 수립
정답 · 해설 보기
정답 ①
빅데이터 분석 방법론의 분석 기획 단계의 주요 태스크는 비즈니스 이해 및 프로젝트 범위 설정, 프로젝트 정의 및 계획 수립, 프로젝트 위험 계획 수립입니다. 필요 데이터 정의는 분석 기획이 아니라 그다음 단계인 데이터 준비 단계의 작업입니다. 시험 포인트: 분석 절차 = 분석 기획 → 데이터 준비 → 데이터 분석 → 시스템 구현 → 평가 및 전개
문제 11
단원 분석 기획 기본
다음 분석과제의 특징 중 Accuracy와 Precision에 대한 설명으로 틀린 것은?
①분석의 활용적인 측면에서는 Accuracy가 중요하며, 안정적인 측면에서는 Precision이 중요하다.
②Accuracy와 Precision의 관계는 트레이드 오프(Trade-off)가 되는 경우가 많다.
③Accuracy는 True로 예측된 것 중 실제 True인 것의 비율, Precision은 실제 True인 것 중 True로 예측된 것의 비율이다.
④Precision은 모델을 반복했을 때의 편차를 의미한다.
정답 · 해설 보기
정답 ③
Accuracy는 모델과 실제 값의 차이로 분석의 활용적 측면에서 중요하고, Precision은 모델을 반복했을 때의 편차로 안정성 측면에서 중요하며, 둘은 트레이드 오프인 경우가 많습니다. Accuracy를 'True로 예측된 것 중 실제 True인 비율', Precision을 '실제 True인 것 중 True로 예측된 비율'로 설명한 문장은 틀렸습니다. 분류 평가지표에서 Accuracy는 전체 중 맞힌 비율이고 Precision은 True로 예측한 것 중 실제 True인 비율입니다. 시험 포인트: Accuracy = 활용 측면(모델과 실제의 차이), Precision = 안정성 측면(반복 시 편차), 둘은 트레이드 오프
문제 12
단원 마스터 플랜·거버넌스
다음은 데이터 거버넌스 중 무엇에 관한 설명인가? 데이터의 표준용어 설정, 명명규칙 수립, 메타 데이터 구축, 데이터 사전 구축
①데이터 표준화
②표준화 활동
③데이터 저장 관리
④데이터 관리 체계
정답 · 해설 보기
정답 ①
데이터의 표준용어 설정, 명명규칙 수립, 메타 데이터 구축, 데이터 사전 구축은 데이터 거버넌스 중 데이터 표준화에 관한 설명입니다. 데이터 관리 체계는 메타데이터와 데이터 사전의 관리 원칙을 세우는 것이고, 데이터 저장소 관리는 전사 차원의 저장소를 구성하는 것이며, 표준화 활동은 표준 준수 여부를 점검·모니터링하는 것입니다. 시험 포인트: 데이터 표준화 = 표준용어·명명규칙·메타데이터·데이터 사전 구축
문제 13
단원 마스터 플랜·거버넌스
다음 중 과제의 우선순위를 결정할 때 고려하는 요소가 아닌 것은?
①전략적 중요도
②비즈니스 성과/ROI
③실행 용이성
④기술 적용 수준
정답 · 해설 보기
정답 ④
과제의 우선순위를 결정할 때 고려하는 요소는 전략적 중요도, 비즈니스 성과/ROI, 실행 용이성입니다. 기술 적용 수준은 우선순위 요소가 아니라 적용 범위/방식을 정할 때 고려하는 요소(업무 내재화 적용 수준, 분석 데이터 적용 수준, 기술 적용 수준)입니다. 시험 포인트: 우선순위 고려 = 전략적 중요도·ROI·실행 용이성 / 적용 범위·방식 고려 = 업무 내재화·분석 데이터·기술 적용 수준
문제 14
단원 분석 과제 발굴
빈칸에 들어갈 내용으로 알맞은 것은? 상향식접근법은 기업에서 보유하고 있는 다양한 원천 데이터로부터의 ( A )을/를 통하여 ( B )을/를 얻을 수 있다. 상향식은 디자인 사고 중 ( C )에 해당한다.
①A: 발견, B: 통찰, C: 발산
②A: 인지, B: 통찰, C: 발산
③A: 통찰, B: 발산, C:수렴
④A: 발산, B: 통찰, C:수렴
정답 · 해설 보기
정답 ①
상향식 접근법은 기업이 보유한 다양한 원천 데이터로부터의 발견을 통해 통찰을 얻을 수 있는 방식이고, 디자인 사고에서는 발산 단계에 해당합니다. 하향식 접근법은 솔루션, 최적화와 관련이 있고 디자인 사고의 수렴 단계에 해당합니다. 시험 포인트: 상향식 = 발견 → 통찰, 디자인 사고의 발산 / 하향식 = 솔루션·최적화, 수렴
문제 15
단원 분석 방법론
데이터 마이닝 프로세스에서 모델링 기법에 따라 변수를 정의하고 데이터를 데이터 마이닝 소프트웨어에 적용할 수 있도록 적합한 형식으로 변환하는 활동 수행 단계는 무엇인가?
①데이터 가공
②데이터 준비
③모델 검증
④데이터 마이닝 기법적
정답 · 해설 보기
정답 ①
데이터 마이닝 프로세스는 목적 설정, 데이터 준비, 데이터 가공, 데이터 마이닝 기법 적용, 검증 순입니다. 모델링 기법에 따라 변수를 정의하고 데이터를 데이터 마이닝 소프트웨어에 적용할 수 있는 형식으로 변환하는 활동은 데이터 가공입니다. 데이터 준비는 데이터 정제로 품질을 보장하고 필요하면 데이터 양을 보충하는 단계입니다. 시험 포인트: 데이터 마이닝 = 목적 설정 → 데이터 준비 → 데이터 가공 → 기법 적용 → 검증
문제 16
단원 마스터 플랜·거버넌스
다음 중 기업의 분석 성숙도 진단 대상이 아닌 것은?
①비즈니스 부문
②조직/역량 부문
③서비스 부문
④IT부문
정답 · 해설 보기
정답 ③
기업의 분석 성숙도는 비즈니스 부문, 조직/역량 부문, IT 부문을 대상으로 진단하고, 성숙도 수준에 따라 도입, 활용, 확산, 최적화 단계로 구분합니다. 서비스 부문은 진단 대상이 아닙니다. 시험 포인트: 분석 성숙도 진단 대상 = 비즈니스·조직/역량·IT 부문
문제 43
단원 분석 기획 기본
기업의 경영목표 달성에 필요한 전략적 주요 정보를 포착하고, 주요 정보를 지원하기 위해 전사적 관점의 정보 구조를 도출하며, 이를 수행하기 위한 전략 및 실행 계획을 수립하는 전사적인 종합추진 계획을 무엇이라 하는가?
정답 · 해설 보기
정답 ISP (단답형)
전사적 관점에서 정보 구조를 도출하고 이를 수행할 전략과 실행 계획을 세우는 종합추진 계획은 ISP(정보전략계획, Information Strategy Planning)입니다. BPR은 업무 프로세스를 근본적으로 재설계하는 활동, ERP는 전사적 자원 관리 시스템, EAI는 기업 내 애플리케이션을 통합하는 솔루션입니다. 시험 포인트: ISP = 전사 정보 구조 도출 + 전략·실행 계획 수립, BPR = 업무 재설계, ERP = 전사 자원 관리, EAI = 애플리케이션 통합
문제 44
단원 분석 방법론
다음은 어떤 분석 모델 프로세스에 관한 설명인가? 사용자 요구사항이나 데이터를 정확히 규정하기 어렵고 데이터 소스도 명확히 파악하기 어려운 상황에서 사용, 일단 분석을 시도해보고 그 결과를 확인해가면서 반복적으로 개선해 나가는 방법을 취한다.
정답 · 해설 보기
정답 프로토타입 모델 (단답형)
요구사항이나 데이터 소스가 불명확한 상황에서 일단 분석을 시도하고 결과를 확인하며 반복적으로 개선해 나가는 방식은 프로토타입 모델입니다. 폭포수 모델은 단계를 순차적으로 진행하는 방식이고, 나선형 모델은 계획·위험 분석·개발·평가를 여러 번 되풀이하며 점진적으로 완성하는 방식입니다. 계층적 프로세스 모델은 단계-태스크-스텝으로 구성되는 빅데이터 분석 방법론의 구조입니다. 시험 포인트: 프로토타입 모델 = 요구사항 불명확 시 시험 분석 후 반복 개선, 폭포수 = 순차 진행, 나선형 = 반복하며 위험 분석
데이터 분석
문제 17
단원 정형 데이터 마이닝
구축된 모델을 평가하여 과대적합 또는 과소적합을 미세조정 하는데 활용하는 데이터는 무엇인가?
①학습 데이터(train data)
②검증 데이터(validation data)
③평가 데이터 (test data)
④증강 데이터
정답 · 해설 보기
정답 ②
구축된 모델의 과대적합이나 과소적합을 미세 조정할 때 쓰는 데이터는 검증 데이터입니다. 학습 데이터는 모델을 학습시키는 데이터, 평가(테스트) 데이터는 학습이 끝난 뒤 성능을 확인하는 데이터이며, 검증 데이터는 학습 중 과적합 여부 확인이나 조기 종료에 쓰입니다. 시험 포인트: 학습 = 모델 학습, 검증 = 학습 중 성능·과적합 점검, 평가(테스트) = 학습 후 최종 성능 확인
문제 18
단원 R·데이터 전처리
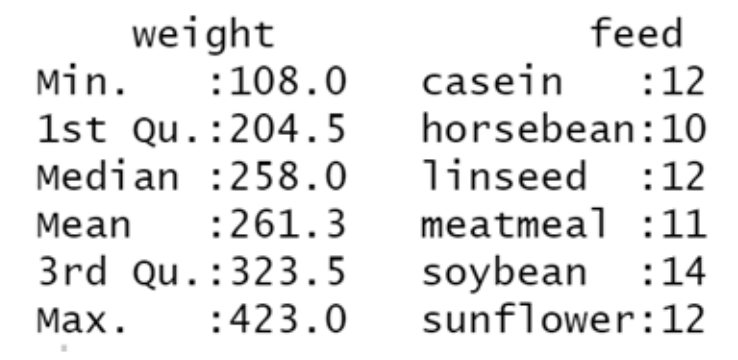
6개의 feed(사료)를 chicken에게 먹인 후 측정한 weight에 대한 summary 결과에 대한 설명으로 틀린 것은?
①weight 중앙값은 261.3이다.
②총 데이터 개수는 71개 이다.
③casein 사료를 먹은 chicken은 12마리이다.
④feed는 평균 계산을 할 수 없다.
정답 · 해설 보기
정답 ①
summary 결과에서 weight의 중앙값은 Median 항목인 258.0이고 261.3은 평균(Mean)입니다. 그래서 중앙값이 261.3이라는 설명이 틀렸습니다. feed의 빈도를 모두 더하면 12+10+12+11+14+12=71개이고, casein 사료를 먹은 닭은 12마리이며, feed는 범주형이라 평균을 계산할 수 없습니다. 시험 포인트: summary()에서 중앙값 = Median, 평균 = Mean, 범주형 변수 = 수준별 빈도
문제 19
단원 시계열·차원 축소
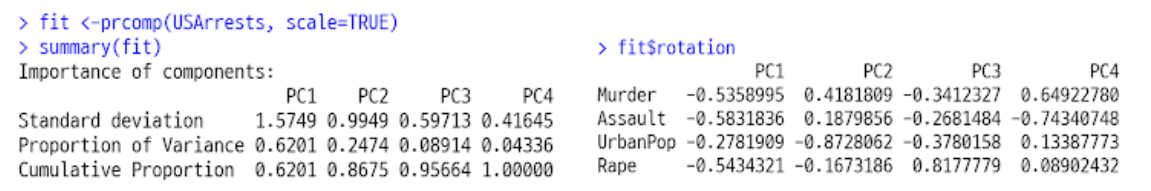
다음은 4개의 변수를 가진 USArrests 데이터에 주성분분석을 적용해서 얻은 결과이다. 제1주성분을 구하는 식으로 옳은 것은?
제1주성분(PC1)의 식은 rotation 표의 PC1 열 계수로 만듭니다. PC1 열이 Murder −0.536, Assault −0.583, UrbanPop −0.278, Rape −0.543이므로 이 계수로 이루어진 식이 제1주성분입니다. 나머지 식은 PC1 열의 값과 다릅니다. 시험 포인트: 주성분 식 = rotation 표의 해당 PC 열 계수를 변수에 곱해 더한 선형결합
문제 20
단원 통계 분석
붓스트랩핑을 통해 한 샘플이 뽑힐 확률이 1/d 라고 했을 때, 샘플 추출을 d번 진행하였을 때 어떤 샘플이 한 번도 뽑히지 않을 확률은?
①$(1-1/d)^2$
②$(1+d)^2$
③$(1-1/d)^d$
④$\sqrt{1-1/d}$
정답 · 해설 보기
정답 ③
붓스트랩에서 한 샘플이 한 번의 추출에서 뽑힐 확률이 1/d이면 뽑히지 않을 확률은 1−1/d입니다. 추출을 d번 독립적으로 반복하면 한 번도 뽑히지 않을 확률은 (1−1/d)를 d번 곱한 (1−1/d)^d입니다. 시험 포인트: 붓스트랩에서 한 번도 뽑히지 않을 확률 = (1 − 1/d)^d (d가 크면 약 0.368)
문제 21
단원 정형 데이터 마이닝
다음의 거리표를 사용해 최단 연결법으로 계층적 군집화를 할 경우, 첫 번째 단계에서 형성되는 군집과 a와의 거리는 무엇인가? 데이터(x1, x2): a(1, 4), b(2, 1), c(4, 6), d(4, 3), e(5, 1) 거리표: b-a 3.2 / c-a 3.6, c-b 5.4 / d-a 3.2, d-b 2.8, d-c 3.0 / e-a 5.0, e-b 3.0, e-c 5.1, e-d 2.2
①3.6
②2.2
③3.2
④5.0
정답 · 해설 보기
정답 ③
최단연결법은 먼저 거리가 가장 작은 두 점을 묶습니다. 거리표에서 가장 작은 값은 d와 e의 2.2이므로 첫 단계에서 {d, e} 군집이 만들어집니다. 이 군집과 a의 거리는 최단연결법이므로 d-a 거리 3.2와 e-a 거리 5.0 중 작은 3.2입니다. 시험 포인트: 최단연결법 = 군집 간 거리를 구성원 간 거리의 최솟값으로 정의
문제 22
단원 통계 분석
통계적 가설검정에 대한 내용중 틀린 것은?
①귀무가설이 참인 경우 이것을 기각하여 발생하는 오류를 제 1종오류라고 한다.
②귀무가설이 거짓인 경우 이것을 채택하여 발생하는 오류를 제 2종오류라고 한다.
③유의확률이 유의수준보다 작을 때 귀무 가설을 기각하게 된다.
④p-value가 작을수록 해당 검정통계량의 관측값은 귀무 가설을 지지하는 것으로 해석가능하다.
정답 · 해설 보기
정답 ④
p-value는 귀무가설이 맞다고 가정할 때 관측된 값 이상으로 극단적인 값이 나올 확률입니다. p-value가 작을수록 귀무가설에 불리한 증거이므로, p-value가 작을수록 귀무가설을 지지한다는 해석이 틀렸습니다. 유의확률이 유의수준보다 작으면 귀무가설을 기각합니다. 시험 포인트: p-value가 작을수록 귀무가설 기각 쪽, p-value < 유의수준 → 귀무가설 기각
문제 23
단원 통계 분석
다음 회귀분석에 대한 설명 중 옳은 것은?
①명목형 변수는 더미변수화 하여 사용할 수 없다.
②독립변수의 수가 많아지면 모델의 설명력이 증가하고 모형이 단순해 진다.
③종속변수들 간 강한 상관관계가 나타나는 다중공선성 문제가 발생할 수 있다.
④독립변수와 종속변수의 사이를 모형으로 나타내고 두 변수 관계를 도출하는 것이다.
정답 · 해설 보기
정답 ④
회귀분석은 독립변수와 종속변수 사이의 관계를 모형으로 나타내고 두 변수 사이의 관계를 도출하는 분석입니다. 명목형 변수는 더미변수로 바꿔 사용할 수 있고, 독립변수가 많아지면 설명력은 늘 수 있어도 모형은 복잡해지며, 다중공선성은 종속변수가 아니라 독립변수들 사이의 강한 상관관계로 생기는 문제입니다. 시험 포인트: 회귀분석 = 독립변수-종속변수 관계 모형화, 명목형 변수 = 더미변수, 다중공선성 = 독립변수 간 상관
문제 24
단원 통계 분석
다음 중 다중공선성(multicollinearity)에 대한 설명으로 옳지 않은 것은?
①다중공선성에 대한 측정은 VIF를 사용한다.
②다중공선성이 발생하는 독립변수들은 표본의 크기에 관계없이 발생하게 된다.
③독립변수간 높은 상관관계를 갖을 때 다중공선성의 발생이 높다.
④중대한 다중공선성은 회귀계수의 분산을 증가시켜 불안정하고 해석하기 어렵게 만든다.
정답 · 해설 보기
정답 ②
다중공선성은 일부 설명변수가 다른 설명변수와 상관되어 있을 때 발생하고, VIF로 측정하며 보통 VIF가 10을 넘으면 문제가 있다고 봅니다. 중대한 다중공선성은 회귀계수의 분산을 키워 모형을 불안정하게 만듭니다. 표본의 크기가 작으면 변수 간 상관관계를 정확히 파악하기 어려워 다중공선성을 판단하기도 어려워지므로, 표본 크기와 관계없이 발생한다는 설명은 옳지 않습니다. 시험 포인트: 다중공선성 = 독립변수 간 높은 상관, VIF > 10이면 의심, 회귀계수 분산 증가
문제 25
단원 시계열·차원 축소
다음 중 주성분 분석에 대한 설명으로 부적절한 것은?
①차원축소 방법 중 하나이다.
②비지도학습(unsupervised learning)에 해당한다.
③이론적으로 주성분 간 상관관계가 없다.
④원변수의 선형결합 중 가장 분산이 작은 것을 제1주성분(PC1)으로 설정한다.
정답 · 해설 보기
정답 ④
주성분 분석은 차원 축소에 쓰는 비지도 학습 기법이며, 주성분들은 서로 상관관계가 없습니다. 원변수의 선형결합 중 분산이 가장 큰 것을 제1주성분으로 설정하므로, 가장 분산이 작은 것을 제1주성분으로 설정한다는 설명이 부적절합니다. 시험 포인트: 주성분 분석 = 비지도·차원 축소, 분산이 가장 큰 선형결합이 제1주성분, 주성분 간 무상관
문제 26
단원 정형 데이터 마이닝
신경망 모형에서 입력 받은 데이터를 다음 층(Layer)으로 출력하는 형태를 결정하는 함수를 무엇이라 하는가?
①활성화 함수(activation function)
②로짓 함수
③오즈비 함수
④매핑 함수
정답 · 해설 보기
정답 ①
신경망에서 입력받은 데이터를 다음 층으로 어떤 형태로 출력할지 결정하는 함수는 활성화 함수입니다. 결괏값을 내보낼 때 쓰고, 풀려는 문제의 종류에 따라 선택이 달라지며, 시그모이드를 쓰는 경우 은닉층이 많아지면 기울기 소실 문제가 생길 수 있습니다. 시험 포인트: 활성화 함수 = 다음 층으로의 출력 형태를 결정(시그모이드·ReLU·소프트맥스 등)
문제 27
단원 통계 분석
데이터 탐색 단계에서 고려해야 할 사항으로 가장 적절하지 않은 것은?
①이상값을 확인하여 원인을 파악하고, 삭제, 대체, 변환 등의 처리를 한다.
②데이터의 종류, 분포 등을 파악하고 변수들 간의 관계를 알아본다.
③변수들 간의 상관관계 및 연관성을 분석해 유의미한 변수를 식별한다.
④결측값을 확인하여 결측값이 있을 경우 제거하는 것이 바람직하다.
정답 · 해설 보기
정답 ④
데이터 탐색 단계에서는 이상값의 원인을 파악해 삭제, 대체, 변환을 고려하고, 데이터의 종류와 분포, 변수들 간의 관계와 상관관계를 살펴 유의미한 변수를 식별합니다. 결측값은 있다고 무조건 제거하는 것이 아니라 상황에 따라 판단해야 하므로 제거하는 것이 바람직하다는 설명이 가장 적절하지 않습니다. 시험 포인트: 결측값 = 무조건 제거 금지, 상황에 따라 대체·제거 판단
문제 28
단원 시계열·차원 축소
ARMA(2, 0)에 대한 설명으로 올바른 것은 무엇인가?
①정상시계열이 되기 위해 2차 차분이 필요하다.
②PACF는 3차항부터 절단 형태가 되고 ACF는 지수적으로 감소한다.
③ARMA(2, 0)은 MA(2)와 같은 모형이라고 할 수 있다.
④ARMA(2, 0)은 비정상 시계열이어서 차분처리 후, 분석 용도로 사용할 수 없다.
정답 · 해설 보기
정답 ②
ARMA(2, 0)은 MA 부분이 없으므로 AR(2) 모형과 같습니다. AR(2)는 PACF가 3차 항부터 절단 형태를 보이고 ACF는 지수적으로 감소합니다. ARMA(2, 0)은 정상 시계열이어서 차분 없이 분석에 쓸 수 있습니다. MA(2)라면 PACF가 지수적으로 감소하고 ACF가 3차 항부터 절단됩니다. 시험 포인트: AR(p) = PACF p+1차부터 절단·ACF 지수 감소, MA(q) = ACF q+1차부터 절단·PACF 지수 감소
문제 29
단원 시계열·차원 축소
다음 시계열 모형에 대한 설명 중 옳지 않은 것은 무엇인가?
①MA 모형은 정상성을 만족하기 위한 조건이 필요하다.
②AR모형은 백색 잡음의 현재 값과 자기 자신의 과거 값의 선형 가중값으로 이루어진 정상 확률모형이다.
③MA는 현시점의 자료가 유한 개의 과거 백색잡음의 선형결합으로 표현되어 있는 모형이다.
④ARIMA는 비정상 시계열이며 차분/변환을 통해 AR, MA, ARMA 모형으로 정상화 할 수 있다.
정답 · 해설 보기
정답 ①
MA 모형은 현 시점의 자료를 유한 개의 과거 백색잡음의 선형결합으로 표현하는 모형으로, 항상 정상성을 만족하므로 정상성을 위한 별도의 조건이 필요하지 않습니다. AR 모형은 정상성을 위한 조건이 필요합니다. ARIMA는 비정상 시계열을 차분이나 변환으로 정상화해 AR, MA, ARMA 모형으로 분석합니다. 시험 포인트: MA = 항상 정상(별도 조건 불필요), AR = 정상성 조건 필요, ARIMA = 비정상 시계열(차분·변환)
문제 30
단원 통계 분석
회귀분석의 분석 결과 해석에 대한 설명으로 옳지 않은 것은?
①모델의 통계적 유의성은 F통계량과 p-value를 통해 확인한다.
②회귀계수의 유의성 검증은 t값과 p-value를 통해 확인한다.
③결정계수가 커질수록 회귀방적식의 설명력이 높아진다.
④결정계수는 -1~1사이의 값을 갖는다.
정답 · 해설 보기
정답 ④
모델의 통계적 유의성은 F통계량과 p-value로, 회귀계수의 유의성은 t값과 p-value로 확인합니다. 결정계수는 SSR/SST(=1−SSE/SST)로 0에서 1 사이의 값을 가지며 클수록 설명력이 높습니다. 따라서 결정계수가 −1~1 사이의 값을 갖는다는 설명이 옳지 않습니다. 시험 포인트: 결정계수 R² = SSR/SST, 0~1 범위(상관계수는 −1~1)
문제 31
단원 통계 분석
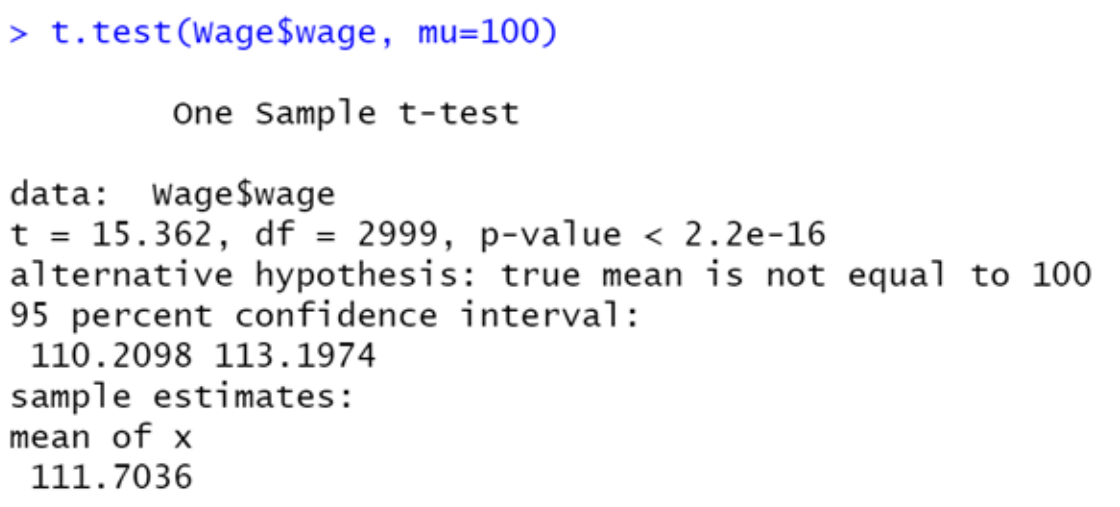
다음 Wage 데이터의 wage 변수에 대한 t검정 결과에 대한 해석으로 옳지 않은 것은 무엇인가?
①자유도(degree of freedom)는 2999이다.
②유의수준 0.05일 때 귀무가설은 기각되지 않는다.
③대립가설은 ‘wage의 평균은 100과 같지 않다’이다.
④95% 신뢰구간에 점추정 값이 포함되어 있다.
정답 · 해설 보기
정답 ②
일표본 t검정에서 p-value가 2.2e-16으로 유의수준 0.05보다 훨씬 작으므로 귀무가설(평균이 100이다)이 기각되고 대립가설(평균이 100과 같지 않다)이 채택됩니다. 그래서 귀무가설이 기각되지 않는다는 설명이 옳지 않습니다. 자유도는 2999이고 95% 신뢰구간(110.2~113.2)에 표본평균 111.7이 들어 있습니다. 시험 포인트: p-value < 유의수준 → 귀무가설 기각·대립가설 채택, 일표본 t검정 자유도 = n−1
문제 32
단원 통계 분석
다음 중 다차원척도법에 대한 설명으로 적절한 것은 무엇인가?
①데이터를 고차원에서 저차원으로 축소하는 방법으로 독립변수들간 다중공선성 문제를 해결할 수 있다.
②다차원척도법에서 개체들 간의 유사성 측정에는 밀도 개념을 사용한다.
③관측 대상의 상대적 거리의 정확도를 높이기 위해 적합 정도를 스트레스 값(Stress Value)로 나타내며, 1 에 가까울수록 적합도가 좋다.
④상관관계가 있는 변수들을 선형 결합에 의해 상관관계가 없는 새로운 변수를 만들고 분산을 극대화하는 변수로 축약한다.
정답 · 해설 보기
정답 ①
다차원척도법(MDS)은 개체 사이의 거리(유사성·비유사성)를 보존하면서 고차원 데이터를 2차원이나 3차원 공간의 점으로 옮겨 표현하는 차원 축소 기법입니다. 많은 변수를 적은 수의 좌표로 줄여 표현하므로 변수들이 서로 강하게 얽혀 생기는 다중공선성 문제를 피하는 데에도 활용할 수 있다고 봅니다. 개체 간 유사성은 밀도가 아니라 유클리드 거리 등 거리 개념으로 측정하고, 적합도를 나타내는 스트레스 값은 1이 아니라 0에 가까울수록 좋습니다. 상관관계가 있는 변수들을 선형결합해 서로 무상관이면서 분산을 최대로 하는 새 변수로 축약하는 것은 주성분 분석입니다. [출제 논란] 정답 논란: 독립변수 간 다중공선성을 해결하는 대표적 방법은 주성분 분석이라 이를 다차원척도법의 설명으로 보기에는 무리가 있다는 지적이 있습니다. 또 36회 31번은 MDS를 차원 축소 목적으로 쓴다는 설명을 틀린 것으로 처리해 두 회차의 정답 논리가 서로 맞지 않습니다. 패스뱅크는 각 회차의 시행처 정답을 따릅니다. 시험 포인트: MDS = 거리 기반·저차원 점 표현·스트레스 값 0에 가까울수록 적합, 분산 최대 선형결합 = 주성분 분석
문제 33
단원 정형 데이터 마이닝
인공신경망 모형에 대한 설명으로 옳지 않은 것은?
①인간두뇌의 학습과정을 뉴런과 시냅스의 상호작용을 연산과정으로 간주하고 이를 재현한 분류, 예측 모델이다.
②복잡한 비선형 관계 모델링과 대용량 데이터 처리가 가능한 장점이 있다.
③은닉층을 포함하고 있어 모델해석이 어렵고 초기 가중치 설정이 어렵다.
④은닉층 수와 노드의 수는 자동으로 설정되며 은닉층이 많을수록 예측력이 우수하다.
정답 · 해설 보기
정답 ④
인공신경망은 뉴런과 시냅스의 상호작용을 연산으로 재현한 분류·예측 모델로 복잡한 비선형 관계 모델링과 대용량 데이터 처리가 가능합니다. 은닉층 때문에 모델 해석이 어렵고 초기 가중치 설정이 어렵습니다. 은닉층 수와 노드 수는 사용자가 지정하는 하이퍼파라미터이고 많을수록 과대적합 위험이 있어 적절히 조정해야 하므로, 자동 설정된다는 설명이 옳지 않습니다. 시험 포인트: 은닉층 수·노드 수 = 사용자가 정하는 하이퍼파라미터, 많을수록 과대적합 위험
문제 34
단원 정형 데이터 마이닝
다음 중 연관분석에 대한 설명으로 옳지 않은 것은 무엇인가?
①사건들이 어떤 순서로 일어나고 이 사건들 사이에 연관성을 알아내는 것이 시차연관분석이지만 원인과 결과의 형태로 해석되지 않는다.
②조건반응(if-then)으로 표현되어 결과를 이해하기 쉽다.
③너무 세분화된 품목을 가지고 연관규칙을 찾으려면 의미 없는 분석 결과가 도출될 수 있다.
④강력한 비목적성 분석 기법이다.
정답 · 해설 보기
정답 ①
시차연관분석은 사건들이 어떤 순서로 일어나는지를 분석해 시간적 선후 관계를 알아내는 기법이며, 원인-결과 관계를 파악하는 데 유용한 분석 도구입니다. 그래서 원인과 결과의 형태로 해석되지 않는다는 설명이 옳지 않습니다. 연관분석은 조건반응(if-then)으로 결과를 이해하기 쉽고 강력한 비목적성 분석 기법이지만, 너무 세분화된 품목은 의미 없는 결과를 낼 수 있습니다. 시험 포인트: 시차연관분석 = 사건 순서 분석, 원인-결과 파악에 유용 / 연관분석 = 비목적성·if-then 규칙
문제 35
단원 정형 데이터 마이닝
혼합분포군집 모형에서 최대가능도(Maximum Likelihood Estimation)와 관련 있는 알고리즘은 무엇인가?
①K-Means
②DBSCAN
③K-Medoids
④EM 알고리즘
정답 · 해설 보기
정답 ④
혼합분포군집에서는 데이터를 k개의 모수적 모형의 가중합으로 설명하고, 모수와 가중치를 추정할 때 EM(Expectation Maximization) 알고리즘을 사용합니다. 최대가능도 추정과 관련 있는 알고리즘이 EM 알고리즘입니다. K-Means, DBSCAN, K-Medoids는 이 모형과 관련이 없는 군집 방법입니다. 시험 포인트: 혼합분포군집 = 모수와 가중치를 EM 알고리즘으로 추정(최대가능도)
문제 36
단원 통계 분석
모분산 추정에 대한 설명으로 옳지 않은 것은 무엇인가?
①모집단의 변동성 또는 퍼짐의 정도에 관심이 있는 경우, 모분산이 추론의 대상이 된다.
②N개 집단에 대한 분산 검정은 자유도가 N-1 인 카이제곱검정을 따른다.
③모집단이 정규분포를 따르지 않더라도 중심극한 정리를 통해 정규모집단으로부터의 모분산에 대한 검정을 유사하게 시행할 수 있다.
④이표본(two sample) 에 의한 분산비 검정은 두 표본의 분산이 동일한지를 비교하는 검정으로 검정통계량은 F 분포를 따른다.
정답 · 해설 보기
정답 ②
1개 집단에 대한 분산 검정은 자유도가 N−1인 카이제곱검정을 따릅니다. N개 집단에 대한 검정이라고 한 설명은 틀렸습니다. 모분산은 모집단의 변동성과 퍼짐 정도를 알려 주고, 정규분포를 따르지 않는 분포도 중심극한정리를 이용해 추정할 수 있으며, 두 표본의 분산비 검정은 F 분포를 따릅니다. 시험 포인트: 한 집단 분산 검정 = 카이제곱(자유도 N−1), 두 집단 분산비 검정 = F 분포
문제 37
단원 통계 분석
회귀분석에서 유의성 검정을 위한 분산분석표에 대한 설명으로 옳지 않은 것은? 분산분석표: 회귀(자유도 1, 제곱합 100, 평균 100, F값, p-value 0.00004) / 잔차(자유도 10, 제곱합 200, 평균 2) / 전체(자유도 11, 제곱합 300)
①회귀 모형은 5% 수준에서 유의하다.
②오차 분산의 불편추정량이 0.1 이다.
③표본의 개수는 12개이다.
④결정계수는 1/3 이다.
정답 · 해설 보기
정답 ②
분산분석표에서 오차 분산의 불편추정량은 잔차의 평균제곱(MSE = SSE÷잔차 자유도)입니다. 이 문제의 표와 해설지는 그 값을 2로 제시하고 있고(제곱합 200, 자유도 10으로 직접 계산하면 20), 어느 쪽으로 보아도 0.1은 아니므로 그 설명이 옳지 않습니다. 회귀의 p-value가 0.00004로 0.05보다 작아 모형은 5% 수준에서 유의하고, 전체 자유도가 n−1=11이므로 표본은 12개이며, 결정계수는 SSR÷SST=100÷300=1/3입니다. [출제 논란] 출제 오류 가능성: 원본 표의 잔차 평균제곱 2는 제곱합 200을 자유도 10으로 나눈 20과 맞지 않습니다. F값 50과 p-value 0.00004는 평균제곱이 2일 때와 맞으므로 잔차 제곱합(20이어야 함)이 잘못 인쇄됐을 가능성이 큽니다. 어느 쪽이든 0.1은 아니어서 정답에는 영향이 없습니다. 시험 포인트: 오차 분산 불편추정량 = MSE = SSE/(n−k), 결정계수 = SSR/SST, 전체 자유도 = n−1
문제 38
단원 R·데이터 전처리
텍스트마이닝 관련 설명으로 올바르지 않은 것은?
①자연어처리(NLP) 방식으로 특징 추출, 요약, 분류, 군집화 등 의미를 도출하는 분석이다.
②비구조화된 텍스트에서 구조화된 데이터로 변환하는 방법을 코퍼스라고 한다.
③텍스트 마이닝 전처리 작업에는 클렌징, 토큰화, 불용어 제거, 어간 추출, 표제어 추출 등이 있다.
④감정분석 및 워드 클라우드 등의 패턴 분석을 할 수 있다.
정답 · 해설 보기
정답 ②
코퍼스는 자연어 연구를 위해 특정한 목적을 갖고 언어의 표본을 추출한 집합입니다. 비구조화된 텍스트를 구조화된 데이터로 변환하는 방법은 코퍼스가 아니라 Text To Vector 같은 변환 기법(Bag of words, TF-IDF, Word2Vec 등)입니다. 그래서 코퍼스라고 한다는 설명이 올바르지 않습니다. 시험 포인트: 코퍼스 = 언어 표본 집합, 텍스트 → 벡터 변환 = Bag of words·TF-IDF·Word2Vec
문제 39
단원 정형 데이터 마이닝
사회연결망분석에서 연결망을 표현하는 분석 방법으로 옳지 않은 것은?
①K-means
②네트워크 그래프(Network Graph)
③클러스터링(Clustering)
④영향력 분석(Influence Analysis)
정답 · 해설 보기
정답 ①
사회연결망분석에서 연결망을 표현하는 방법에는 노드 및 엣지 리스트, 인접 행렬, 네트워크 그래프, 영향력 분석, 군집화(클러스터링), 전파 분석 등이 있습니다. K-means는 군집분석 알고리즘이지 연결망을 표현하는 분석 방법이 아니므로 옳지 않습니다. 시험 포인트: 사회연결망분석 표현 = 노드/엣지 리스트·인접 행렬·네트워크 그래프·영향력 분석·군집화·전파
문제 40
단원 R·데이터 전처리
사회관계망분석(Social Network Analysis)에서 중심성 분석으로 적절하지 않은 것은?
①연결중심성(Degree centrality)
②근접중심성(Closeness centrality)
③매개중심성(Betweenness centrality)
④링크중심성(Link centrality)
정답 · 해설 보기
정답 ④
사회관계망분석(SNA)에서 중심성은 한 행위자가 전체 연결망에서 중심에 위치하는 정도이며, 연결(Degree) 중심성, 근접(Closeness) 중심성, 매개(Betweenness) 중심성, 위세(Eigenvector) 중심성이 있습니다. 링크 중심성은 중심성 분석의 종류가 아니므로 적절하지 않습니다. 시험 포인트: SNA 중심성 = 연결·근접·매개·위세 중심성
문제 45
단원 정형 데이터 마이닝
비지도 신경망으로 고차원의 데이터를 이해하기 쉬운 저차원의 뉴런으로 정렬하여 지도의 형태로 형상화 하는 알고리즘을 무엇이라고 하는가?
정답 · 해설 보기
정답 SOM (단답형)
SOM(자기조직화지도, Self-Organizing Map)은 비지도 학습 신경망으로, 고차원 데이터를 2차원 격자 형태의 저차원 뉴런으로 정렬해 지도처럼 시각화합니다. 입력층과 2차원 경쟁층으로 구성되고 차원 축소와 군집화를 동시에 수행합니다. 주성분 분석은 선형 차원 축소 기법이며, K-평균과 DBSCAN은 신경망이 아닌 군집 알고리즘입니다. 시험 포인트: SOM = 비지도 신경망, 입력층 + 2차원 경쟁층, 차원 축소와 군집화를 동시에 수행하며 지도 형태로 시각화
문제 46
단원 정형 데이터 마이닝
다음이 설명하는 앙상블 모형의 종류는 무엇인가? "여러 모델이 순차적인 학습을 하며, 이전 모델의 결과에 따라 다음 모델 표본 추출에서 분류가 잘못된 데이터에 가중치(weight)를 부여하여 표본을 추출 한다."
정답 · 해설 보기
정답 부스팅 (단답형)
이전 모델이 잘못 분류한 데이터에 가중치를 부여해 다음 모델의 표본을 뽑는 순차적 앙상블은 부스팅입니다. 배깅은 부트스트랩 표본으로 여러 모델을 병렬로 학습해 결합하는 방식, 랜덤 포레스트는 배깅에 변수 무작위 선택을 더한 모형, 보팅은 서로 다른 모델의 예측을 투표로 합치는 방식입니다. 대표적인 부스팅으로 AdaBoost, GBM, XGBoost가 있습니다. 시험 포인트: 부스팅 = 순차 학습 + 오분류 데이터 가중치 증가, 배깅 = 부트스트랩 병렬 학습 후 결합
문제 47
단원 정형 데이터 마이닝
어느 마트에서 A제품과 B제품을 판매하고 있다. A제품 → B제품의 지지도는 0.3 이고, 신뢰도가 0.6이다. A제품과 B제품의 판매 수량이 동일할 때, 향상도를 구하시오.
정답 · 해설 보기
정답 1.2 (단답형)
신뢰도 = 지지도 ÷ P(A)이므로 0.6 = 0.3 ÷ P(A)에서 P(A) = 0.5입니다. A와 B의 판매 수량이 같으니 P(B)도 0.5입니다. 향상도 = P(A∩B) ÷ (P(A) × P(B)) = 0.3 ÷ 0.25 = 1.2입니다. 신뢰도 0.6을 P(B) 0.5로 나눠도 같은 값입니다. 시험 포인트: 향상도 = P(A∩B) / (P(A)·P(B)) = 신뢰도 / P(B), 1보다 크면 양의 상관, 1이면 독립
문제 48
단원 통계 분석
회귀모형에 대한 가정에 대한 설명이다. 빈 칸에 알맞은 용어는? - 잔차와 독립변수의 값이 관련되어 있지 않아야 한다. - 독립성 - 잔차들끼리 상관이 없어야 한다. - 비상관성 - ( )이 정규분포를 이뤄야 한다. - 정상성
정답 · 해설 보기
정답 잔차항 (단답형)
회귀모형의 정규성(정상성) 가정은 잔차항이 정규분포를 따라야 한다는 것입니다. 독립성은 잔차와 독립변수의 값이 관련되어 있지 않아야 한다는 것(Durbin-Watson 통계량으로 확인), 비상관성은 잔차들끼리 상관이 없어야 한다는 것입니다. 이 밖에 종속변수가 독립변수에 따라 선형으로 변하는 선형성, 잔차의 분산이 일정한 등분산성도 가정합니다. 시험 포인트: 회귀 가정 = 선형성·독립성·등분산성·비상관성·정규성(잔차항이 정규분포)
문제 49
단원 정형 데이터 마이닝
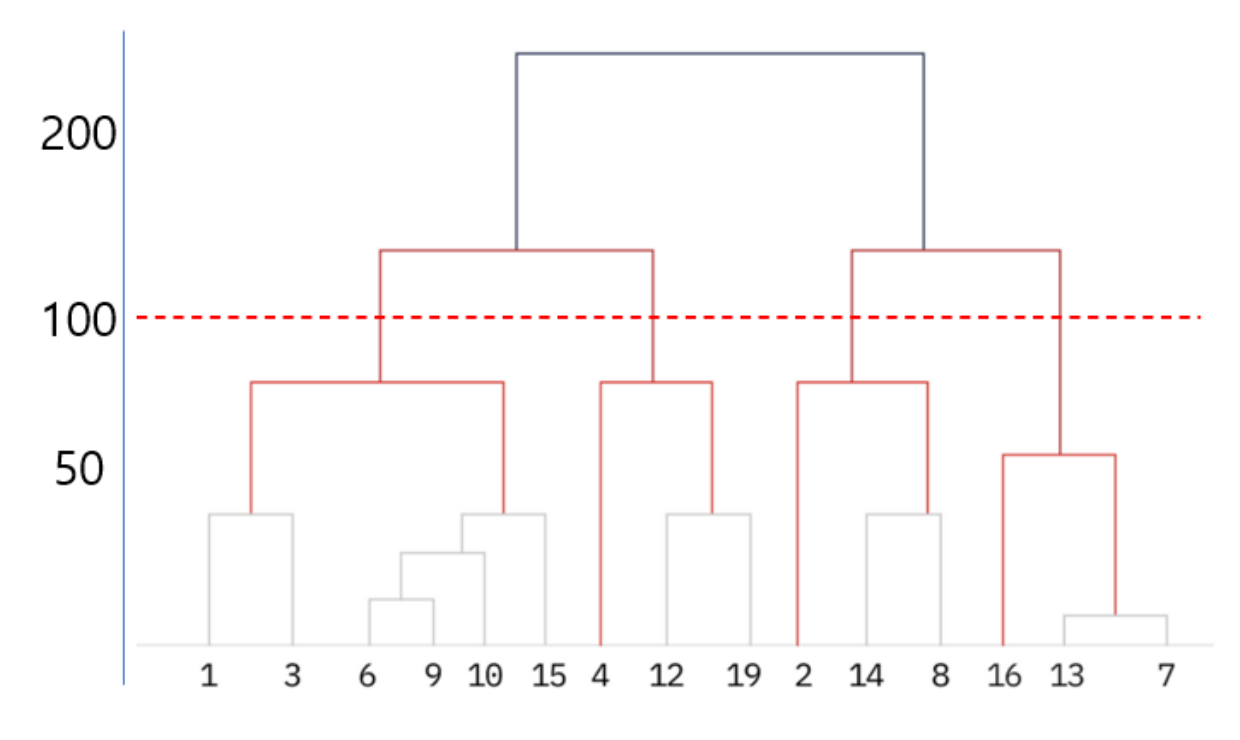
아래의 덴드로그램을 사용하여 100일 때의 군집의 수를 구하여라.
정답 · 해설 보기
정답 4 (단답형)
덴드로그램에서 거리 100 높이에 가로선을 긋고 이 선과 만나는 세로선의 수를 세면 군집 수가 됩니다. 100 높이에서 왼쪽 큰 가지가 둘, 오른쪽 큰 가지가 둘로 나뉘어 있으므로 군집은 4개입니다. 시험 포인트: 덴드로그램 군집 수 = 자르는 높이의 수평선과 교차하는 수직선의 개수
문제 50
단원 정형 데이터 마이닝
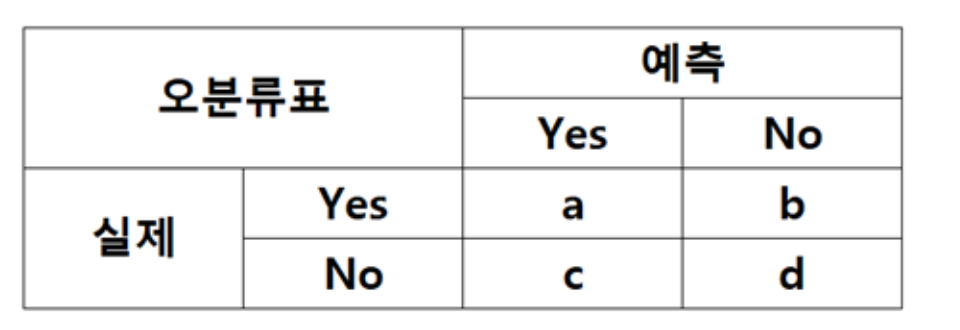
다음 오분류표에서 민감도(Sensitivity)를 구하는 식은 무엇인가?
정답 · 해설 보기
정답 a/(a+b) (단답형)
민감도(재현율)는 실제로 Yes인 것 중에서 Yes로 맞게 예측한 비율이므로 a ÷ (a + b)입니다. d ÷ (c + d)는 실제 No 중 No로 맞힌 비율인 특이도, a ÷ (a + c)는 Yes로 예측한 것 중 맞힌 비율인 정밀도, (a + d) ÷ 전체는 정확도입니다. 시험 포인트: 민감도(재현율) = TP/(TP+FN), 특이도 = TN/(TN+FP), 정밀도 = TP/(TP+FP), 정확도 = (TP+TN)/전체