ADsP 데이터분석 준전문가 38회 필기 기출문제 50문항입니다. 먼저 아래 출제 분석으로 회차의 난이도와 단원 구성을 확인한 뒤, 문제마다 정답 · 해설 보기를 눌러 정답과 해설을 확인하세요.
38회 출제 분석
이 회차는 아직 회원 풀이 기록이 충분하지 않아 정답률을 표시하지 않습니다. 아래는 과목 구성과 문항 정보입니다.
많이 나온 단원은 데이터 이해: 데이터와 정보 5문항, 빅데이터의 가치와 위기 2문항 / 데이터 분석 기획: 마스터 플랜·거버넌스 6문항, 분석 과제 발굴 2문항 / 데이터 분석: 정형 데이터 마이닝 14문항, 통계 분석 14문항입니다.
과목
문항
단원 분포
데이터 이해
10
데이터와 정보 5 · 빅데이터의 가치와 위기 2 · 데이터베이스 활용 2 · 데이터 사이언스·인재 1
데이터 분석 기획
10
마스터 플랜·거버넌스 6 · 분석 과제 발굴 2 · 분석 기획 기본 2
데이터 분석
30
정형 데이터 마이닝 14 · 통계 분석 14 · 시계열·차원 축소 1 · R·데이터 전처리 1
회원 정답률은 패스뱅크 회원이 문제풀이·모의고사에서 실제로 푼 기록을 집계한 값입니다. 문제 하나는 풀이 10건, 과목·단원·회차 묶음은 50건 이상일 때만 표시합니다. 단원은 문제 문장의 핵심 용어로 패스뱅크가 자동 분류한 것이라 공식 출제 기준표의 단원과 다를 수 있습니다.
데이터 이해
문제 1
단원 데이터와 정보
데이터베이스의 구성요소에 대한 설명이다. 각각 무엇에 대한 설명인가? 가. 데이터를 설명해주는 데이터로 데이터의 특성, 구조, 정의 및 관리 정보를 설명하는 데이터 나. 데이터를 빠르게 쉽게 찾을 수 있게 해주는 자료구조
①(가) 테이블, (나) 인덱스
②(가) 메타데이터 (나) 인덱스
③(가) 메타데이터 (나) 속성
④(가) 테이블, (나) 속성
정답 · 해설 보기
정답 ②
(가)는 데이터에 대한 데이터로 데이터의 특성, 구조, 정의, 관리 정보를 설명하는 메타데이터이고, (나)는 데이터를 빠르게 찾을 수 있게 해 주는 자료구조인 인덱스입니다. 테이블은 행과 열로 이루어진 표 형식의 데이터이고, 속성은 테이블의 한 열에 해당하는 데이터입니다. 시험 포인트: 메타데이터 = 데이터에 대한 데이터, 인덱스 = 검색·조회 성능을 높이는 자료구조, 속성 = 테이블의 열
문제 2
단원 데이터베이스 활용
다음 중 상용DB가 아닌 것은 무엇인가?
①DB2
②Tableau
③SQL Server
④Oracle
정답 · 해설 보기
정답 ②
Oracle, SQL Server, DB2는 대표적인 상용 데이터베이스 관리 시스템입니다. Tableau는 데이터를 시각적으로 탐색하고 대시보드와 리포트를 만드는 데이터 시각화·BI 도구이므로 상용 DB가 아닙니다. 시험 포인트: 상용 DB = Oracle·SQL Server·DB2 등, Tableau = 데이터 시각화·BI 도구
문제 3
단원 데이터와 정보
데이터 크기를 작은 것부터 큰 것 순서로 올바르게 나열한 것은?
①PB < EB < ZB < YB
②PB < YB < EB < ZB
③YB < ZB < EB < PB
④PB < ZB < EB < YB
정답 · 해설 보기
정답 ①
데이터 크기 단위는 KB, MB, GB, TB, PB, EB, ZB, YB 순으로 커집니다. 따라서 PB, EB, ZB, YB 순으로 나열한 것이 작은 것부터 큰 것의 올바른 순서입니다. 시험 포인트: 데이터 단위 = KB < MB < GB < TB < PB < EB < ZB < YB (Peta < Exa < Zetta < Yotta)
문제 4
단원 데이터베이스 활용
다음 데이터베이스의 특징에 대한 설명 중 옳지 않은 것은 무엇인가?
①통합된 데이터로 동일한 내용의 데이터가 중복되어 저장된다.
②저장된 데이터로 컴퓨터가 접근할 수 있는 저장매체에 저장된다.
③공용 데이터로 여러 사용자에게 서로 다른 목적으로 데이터가 공동 이용된다.
④변화되는 데이터로 항상 변화하면서도 항상 현재의 정확한 데이터를 유지해야 한다.
정답 · 해설 보기
정답 ①
데이터베이스의 특징은 통합 데이터, 저장 데이터, 공용 데이터, 변화하는 데이터입니다. 통합 데이터는 같은 내용의 데이터가 중복되지 않도록 모아 둔다는 뜻이므로 중복되어 저장된다는 설명이 틀렸습니다. 나머지는 저장 데이터, 공용 데이터, 변화하는 데이터를 옳게 설명했습니다. 시험 포인트: 데이터베이스 특징 = 통합(중복 최소화)·저장·공용·변화하는 데이터
문제 5
단원 빅데이터의 가치와 위기
다음 중 빅데이터 활용을 위한 3요소에 대한 내용으로 틀린 것은?
①데이터 : 모든 것의 데이터화
②기술 : 진화하는 알고리즘, 인공지능
③인력 : 데이터 사이언티스트, 알고리즈미스트
④프로세스 : 이전과는 다른 데이터 관리를 위한 작업 절차
정답 · 해설 보기
정답 ④
빅데이터 활용의 3요소는 데이터(자원), 기술, 인력입니다. 데이터는 모든 것의 데이터화, 기술은 진화하는 알고리즘과 인공지능, 인력은 데이터 사이언티스트와 알고리즈미스트입니다. 프로세스는 3요소가 아니라 데이터 거버넌스의 구성요소이므로 틀린 설명입니다. 시험 포인트: 빅데이터 활용 3요소 = 데이터·기술·인력, 데이터 거버넌스 3요소 = 원칙·조직·프로세스
문제 6
단원 데이터와 정보
다음 중 빅데이터로 인한 본질적인 변화로 옳지 않은 것은? 가. 이미 가치가 있을 것이라고 정해진 특정한 정보만 모아서 처리하던 것을 가능한 많은 데이터를 모으고 다양한 방식으로 조합해 숨은 정보를 찾아낸다. 나. 일부 데이터의 샘플링을 통한 표본조사를 수행하는 환경으로 변화되었다. 다. 질보다 양의 관점을 갖는다. 라. 인과관계에 의한 미래 예측이 데이터 기반의 상관관계 분석을 점점 더 압도하는 추세이다.
①가, 나
②나, 라
③가, 다
④다, 라
정답 · 해설 보기
정답 ②
빅데이터로 인한 본질적 변화는 사전처리에서 사후처리로, 표본조사에서 전수조사로, 질에서 양으로, 인과관계에서 상관관계로의 이동입니다. 나는 표본조사를 수행하는 환경으로 변했다고 해 반대이고, 라는 인과관계에 의한 예측이 상관관계 분석을 압도한다고 해 반대이므로 옳지 않습니다. 시험 포인트: 빅데이터의 변화 = 사전→사후처리, 표본→전수조사, 질→양, 인과→상관관계
문제 7
단원 빅데이터의 가치와 위기
빅데이터의 위기요인이 아닌 것은?
①익명화
②사생활 침해
③데이터 오용
④책임원칙의 훼손
정답 · 해설 보기
정답 ①
빅데이터의 위기요인은 사생활 침해, 책임원칙의 훼손, 데이터 오용입니다. 익명화는 위기요인에 포함되지 않습니다. 사생활 침해는 동의제에서 책임제로, 책임원칙 훼손은 기존 책임원칙 강화로, 데이터 오용은 알고리즘 접근권 허용과 객관적 인증 방안으로 대응합니다. 시험 포인트: 빅데이터 위기요인 = 사생활 침해·책임원칙 훼손·데이터 오용
문제 8
단원 데이터 사이언스·인재
데이터 사이언티스트가 가져야 할 역량 중 종류가 다른 하나는?
①다분야간 협력
②통찰력 있는 분석
③설득력 있는 전달
④빅데이터에 대한 이론적 지식
정답 · 해설 보기
정답 ④
데이터 사이언티스트의 역량은 하드 스킬과 소프트 스킬로 나뉩니다. 통찰력 있는 분석, 설득력 있는 전달, 다분야 간 협력은 소프트 스킬이고, 빅데이터에 대한 이론적 지식은 하드 스킬에 해당하므로 종류가 다릅니다. 시험 포인트: 하드 스킬 = 빅데이터 이론 지식·분석 기술 숙련, 소프트 스킬 = 통찰력·설득력·협력
문제 40
단원 데이터와 정보
기업이 외부 공급업체 또는 제휴업체와 통합된 정보시스템으로 연계하여 시간과 비용을 최적화 시키기 위한 솔루션은 무엇인가?
정답 · 해설 보기
정답 SCM (단답형)
외부 공급업체·제휴업체와 정보시스템을 연계해 물류와 정보 흐름의 시간과 비용을 최적화하는 솔루션은 SCM(공급망 관리)입니다. CRM은 고객 관계 관리, ERP는 기업 내부 자원의 통합 관리, KMS는 지식 관리 시스템입니다. 시험 포인트: SCM = 공급망 전체 연계·최적화, CRM = 고객 관리, ERP = 전사 자원 통합 관리, KMS = 지식 관리
문제 41
단원 데이터와 정보
데이터, 정보, 지식을 통해 최종적으로 지혜를 얻어내는 과정을 계층구조로 설명하는 것은 무엇인가?
정답 · 해설 보기
정답 DIKW (단답형)
데이터(Data), 정보(Information), 지식(Knowledge), 지혜(Wisdom)의 단계를 피라미드로 설명하는 것이 DIKW 계층구조입니다. SECI는 암묵지와 형식지가 상호작용하며 지식이 창출되는 과정을 설명하는 모델이고, ETL은 데이터를 추출·변환·적재하는 절차, KDD는 데이터에서 지식을 발견하는 과정입니다. 시험 포인트: DIKW = 데이터 → 정보 → 지식 → 지혜 계층 피라미드, SECI = 암묵지·형식지 상호작용(공통화·표출화·연결화·내면화)
데이터 분석 기획
문제 9
단원 마스터 플랜·거버넌스
데이터 분석 수준 진단 결과에서 분석 준비도와 분석 성숙도 둘 다 낮은 경우에 해당하는 것은?
①정착형
②확산형
③준비형
④도입형
정답 · 해설 보기
정답 ③
분석 수준 진단에서 준비도와 성숙도가 모두 낮은 기업은 준비형입니다. 준비도가 낮고 성숙도가 높으면 정착형, 준비도가 높고 성숙도가 낮으면 도입형, 둘 다 높으면 확산형입니다. 준비형은 필요한 데이터, 인력, 조직, 분석 업무 등을 먼저 갖춰야 하는 기업입니다. 시험 포인트: 분석 수준 진단 4유형 = 준비형(둘 다 낮음)·정착형·도입형·확산형(둘 다 높음)
문제 10
단원 분석 과제 발굴
다음 중 비즈니스 모델 캔버스를 활용한 과제 발굴의 영역으로 틀린 것은?
①혁신
②업무
③고객
④제품
정답 · 해설 보기
정답 ①
비즈니스 모델 캔버스로 과제를 발굴할 때의 5가지 영역은 업무, 제품, 고객, 지원 인프라, 규제와 감사입니다. 혁신은 이 영역에 포함되지 않으므로 틀린 것입니다. 시험 포인트: 비즈니스 모델 캔버스 과제 발굴 5영역 = 업무·제품·고객·지원 인프라·규제와 감사
문제 11
단원 마스터 플랜·거버넌스
다음 분석과제의 우선순위 선정 관련 설명 중 틀린 것은?
①우선순위를 시급성에 둔다면 Ⅲ - Ⅳ - Ⅱ순서로 진행한다.
②우선순위를 난이도에 둔다면 Ⅲ - Ⅰ - Ⅱ순서로 진행한다.
③시급성과 난이도 둘 다 높은 것이 우선순위가 가장 높다.
④시급성의 판단기준은 전략적 중요도가 핵심이다.
정답 · 해설 보기
정답 ③
분석과제 우선순위는 시급성과 난이도 사분면으로 정합니다. 시급성이 현재이고 난이도가 쉬운 Ⅲ영역이 가장 먼저 추진할 대상입니다. 시급성을 우선하면 Ⅲ→Ⅳ→Ⅱ, 난이도를 우선하면 Ⅲ→Ⅰ→Ⅱ 순서입니다. 시급성과 난이도가 모두 높은 영역이 우선순위가 가장 높다는 설명이 틀렸습니다. 시험 포인트: 분석과제 우선순위 = 시급성·난이도 사분면, 가장 먼저 = 시급성이 현재이고 난이도가 쉬운 Ⅲ영역
문제 12
단원 마스터 플랜·거버넌스
다음 분석 성숙도 관련 내용으로 옳지 않은 것은?
①유사 업종, 경쟁업체와의 비교 분석을 포함한다.
②성숙도 수준에 따라 도입, 활용, 확산, 최적화 단계로 구분해 살펴 볼 수 있다.
③시스템 개발 업무능력과 조직의 성숙도 파악을 위해 CMMI 모델을 활용하여 분석 성숙도를 평가한다.
④데이터 분석 수준 진단은 분석 준비도와 분석 성숙도를 함께 평가함으로써 수행될 수 있다.
정답 · 해설 보기
정답 ①
분석 성숙도 진단은 주로 기업 내부의 데이터 분석 능력과 프로세스를 평가하며, 도입·활용·확산·최적화 단계로 구분하고 CMMI 모델을 활용해 평가합니다. 분석 준비도와 함께 평가하기도 합니다. 유사 업종이나 경쟁업체와의 비교 분석을 포함한다는 설명이 틀렸습니다. 시험 포인트: 분석 성숙도 = 기업 내부 분석 능력·프로세스 진단, 도입→활용→확산→최적화, CMMI 활용
문제 13
단원 마스터 플랜·거버넌스
분석 마스터플랜 수립 시 적용 범위/방식의 고려요소가 아닌 것은?
①업무 내재화 적용 수준
②분석 데이터 적용 수준
③기술 적용 수준
④실행 용이성
정답 · 해설 보기
정답 ④
분석 마스터플랜에서 우선순위 고려요소는 전략적 중요도, ROI, 실행 용이성이고, 적용 범위와 방식의 고려요소는 업무 내재화 적용 수준, 분석 데이터 적용 수준, 기술 적용 수준입니다. 실행 용이성은 우선순위 고려요소이므로 적용 범위/방식의 고려요소가 아닙니다. 시험 포인트: 우선순위 고려 = 전략적 중요도·ROI·실행 용이성 / 적용 범위·방식 고려 = 업무 내재화·분석 데이터·기술 적용 수준
문제 14
단원 마스터 플랜·거버넌스
데이터 분석을 위한 분석 업무 조직 구조에 대한 설명으로 옳지 않은 것은?
①집중형 조직 구조는 일부 협업 부서와 분석 업무가 중복 또는 이원화될 가능성이 있다.
②기능 중심 조직 구조는 전사적 관점에서 핵심 분석이 어렵다.
③분산 조직 구조는 분석 결과 실무 적용에 대한 대응이 느리다.
④분석 조직의 인력들이 협업부서에 배치되어 업무를 수행하는 것은 분산 조직 구조이다.
정답 · 해설 보기
정답 ③
분산 조직 구조는 분석 조직의 인력이 현업 부서에 배치되어 업무를 수행하므로 전사 차원에서 과제의 우선순위를 정해 수행할 수 있고 분석 결과를 신속하게 실무에 적용할 수 있습니다. 그래서 실무 적용에 대한 대응이 느리다는 설명이 틀렸습니다. 시험 포인트: 분산 조직 = 현업 부서 배치·신속한 실무 적용, 집중형 = 업무 중복·이원화 가능성, 기능 중심 = 전사적 핵심 분석 어려움
문제 15
단원 분석 기획 기본
분석 활용 시나리오에 대한 설명으로 틀린 것은?
①데이터 확보가 가장 중요하다.
②데이터 분석을 특정 목적에 맞게 활용하는 방법 또는 계획을 의미한다.
③분석 목표와 분석 방법을 설명하고 예상 결과를 제시하는 문서이다.
④프로젝트 진행 중에도 변경될 수 있다.
정답 · 해설 보기
정답 ①
분석 활용 시나리오에서 가장 중요한 것은 데이터 확보보다 분석의 목표와 목적입니다. 목표와 목적을 정의하지 않으면 데이터 확보, 분석, 결과에 대한 계획을 세우기 어렵습니다. 시나리오는 분석 목표와 방법을 설명하고 예상 결과를 제시하는 문서이며 프로젝트 중에도 바뀔 수 있습니다. 시험 포인트: 분석 활용 시나리오 = 목표·목적이 데이터 확보보다 우선
문제 16
단원 분석 기획 기본
분석 기획 시 고려해야 할 것으로 적절하지 않은 것은?
①데이터 확보가 될 수 있는지, 데이터 유형에 대한 분석이 필요하다.
②비용보다 분석력에 최우선 해야 한다.
③기존에 잘 구현되어 활용되고 있는 유사 시나리오 및 솔루션을 최대한 활용한다.
④장애요소에 대한 사전 계획 수립이 고려 되어야 한다.
정답 · 해설 보기
정답 ②
분석 기획 시에는 확보 가능한 데이터의 유형을 먼저 분석하고, 유사한 시나리오와 솔루션이 있으면 최대한 활용하며, 장애요소에 대한 사전 계획을 세워야 합니다. 비용과 분석력은 서로 보완하는 요소로 균형을 유지해야 하므로 비용보다 분석력을 최우선으로 한다는 설명이 부적절합니다. 시험 포인트: 분석 기획 고려사항 = 가용 데이터 유형 분석·유사 시나리오 활용·장애요소 사전 계획, 비용과 분석력은 균형
문제 42
단원 마스터 플랜·거버넌스
데이터 분석 준비도 프레임워크에서 운영 시스템 데이터 통합, EAI, ETL 등 데이터 유통체계, 분석 전용 서버 및 스토리지, 빅데이터 분석 환경, 비주얼 분석 환경 등과 관련된 항목은 무엇인가?
정답 · 해설 보기
정답 분석 인프라 (단답형)
운영 시스템 데이터 통합, EAI·ETL 같은 데이터 유통체계, 분석 전용 서버와 스토리지, 빅데이터 분석 환경, 비주얼 분석 환경은 분석을 뒷받침하는 시스템 환경에 해당하는 분석 인프라(IT 인프라) 항목입니다. 분석 준비도는 분석 업무 파악, 분석 인력과 조직, 분석 기법, 분석 데이터, 분석 문화, IT 인프라의 여섯 영역으로 평가합니다. 시험 포인트: 분석 준비도 6개 영역 = 분석 업무 파악·인력/조직·분석 기법·분석 데이터·분석 문화·IT 인프라
문제 43
단원 분석 과제 발굴
기존의 논리적인 단계별 접근법에 기반한 문제해결 방식은 최근 복잡하고 다양한 환경에서 발생하는 문제에 적합하지 않을 수 있다. 이를 해결하기 위해 ( )접근법을 통해 전통적인 분석적 사고를 극복하려고 한다. 이 접근법은 상향식 방식의 발산단계와 도출된 옵션을 분석하고 검증하는 하향식 접근 방식의 수렴단계를 반복하여 과제를 발굴한다.
정답 · 해설 보기
정답 디자인 사고 (단답형)
상향식 방식의 발산 단계와 하향식 방식의 수렴 단계를 반복하며 과제를 발굴하는 접근법은 디자인 사고(Design Thinking)입니다. 복잡하고 다양한 환경에서는 논리적 단계별 접근만으로 한계가 있어 이를 보완하는 데 쓰입니다. 발산 단계에서는 가능한 옵션을 폭넓게 찾고, 수렴 단계에서는 도출된 옵션을 분석하고 검증합니다. 시험 포인트: 디자인 사고 = 상향식 발산 + 하향식 수렴 반복으로 과제 발굴
데이터 분석
문제 17
단원 통계 분석
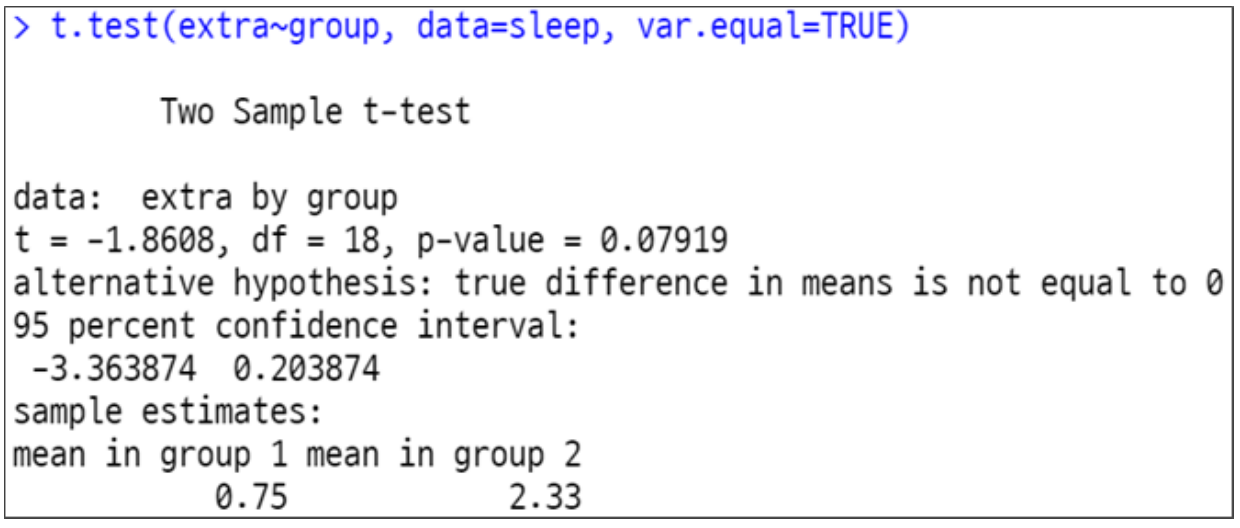
수면유도제 데이터를 통한 t-test 결과이다. 다음 중 결과 해석이 적절하지 않은 것은?
①수면유도제 2가 수면유도제 1보다 효과적이다.
②유의수준 0.05하에서 두 집단의 평균이 동일하다는 귀무가설을 채택할 수 있다.
③두 개의 표본집단이 크기가 클 경우(N>30) 집단의 정규성 검정없이 이 표본 t검정을 사용할 수 있다.
④독립표본 t 검정 분석 전에 등분산 검정을 실시한다.
정답 · 해설 보기
정답 ①
p-value가 0.07919로 유의수준 0.05보다 커서 두 집단의 평균이 같다는 귀무가설을 기각할 수 없습니다. 따라서 수면유도제 2가 1보다 효과적이라고 할 수 없어 그 설명이 부적절합니다. 신뢰구간(−3.36~0.20)이 0을 포함하는 것도 같은 결론을 줍니다. 독립표본 t검정 전에는 등분산 검정을 합니다. 시험 포인트: p-value > 유의수준 → 귀무가설 기각 불가(차이가 있다고 단정할 수 없음)
문제 18
단원 정형 데이터 마이닝
다음 중 분류 모형 평가에 사용되는 도구가 아닌 것은?
①ROC 그래프
②덴드로그램
③향상도 곡선
④이익도표
정답 · 해설 보기
정답 ②
분류 모형 평가에는 오분류표(혼동행렬), ROC 그래프, 향상도 곡선, 이익도표, Kappa 등을 사용합니다. 덴드로그램은 계층적 군집분석 결과를 나무 모양으로 나타낸 그림이므로 분류 모형 평가 도구가 아닙니다. 시험 포인트: 분류 모형 평가 = 오분류표·ROC·향상도 곡선·이익도표, 덴드로그램 = 계층적 군집 결과 그림
문제 19
단원 통계 분석
증거가 확실할 때 가설검정으로 증명하고자 하는 것은?
①귀무가설
②영가설
③대립가설
④기각가설
정답 · 해설 보기
정답 ③
증거가 확실할 때 가설검정으로 증명하려는 것은 대립가설입니다. 귀무가설(영가설)은 가설검정의 대상이 되는 가설로 연구자가 부정하고자 하는 가설이고, 대립가설은 연구자가 입증하기를 기대하는 주장으로 귀무가설이 기각되면 채택됩니다. 시험 포인트: 귀무가설 = 검정의 대상·부정하려는 가설, 대립가설 = 입증하려는 주장(귀무가설 기각 시 채택)
문제 20
단원 정형 데이터 마이닝
다음 중 성격이 다른 한가지는 무엇인가?
①K-means
②Single Linkage Method
③DBSCAN
④주성분 분석
정답 · 해설 보기
정답 ④
K-means, Single Linkage, DBSCAN은 모두 개체를 비슷한 것끼리 묶는 군집분석 방법입니다. 주성분 분석은 변수를 줄이는 차원 축소 기법이어서 성격이 다릅니다. 시험 포인트: 군집분석 = 계층적(최단·최장·중심·평균·와드)·비계층적(K-means·DBSCAN) / 차원 축소 = 주성분 분석·다차원 척도법·요인 분석
문제 21
단원 통계 분석
다음 중 스피어만 상관계수 관련 설명으로 틀린 것은?
①스피어만 상관계수는 비선형적인 관계를 나타낼 수 없다.
②대상자료는 서열척도를 사용한다.
③원시 데이터가 아니라 각 변수에 대해 순위를 매긴 값을 기반으로 한다.
④연속형 외에 이산형 데이터도 사용 가능한다.
정답 · 해설 보기
정답 ①
스피어만 상관계수는 원시 데이터가 아니라 각 변수에 매긴 순위를 기반으로 하므로 서열척도 자료에도 쓸 수 있고, 두 변수 사이의 비선형적인 관계도 나타낼 수 있습니다. 연속형뿐 아니라 이산형 데이터에도 사용합니다. 그래서 비선형 관계를 나타낼 수 없다는 설명이 틀렸습니다. 시험 포인트: 스피어만 상관계수 = 순위 기반·서열척도·비선형 관계도 표현 가능
문제 22
단원 정형 데이터 마이닝
비지도 신경망으로 고차원의 데이터를 이해하기 쉬운 저차원의 뉴런으로 정렬하여 지도의 형태로 형상화 하는 알고리즘을 무엇이라고 하는가?
①SOM
②DBSCAN
③PCA
④EM-알고리즘
정답 · 해설 보기
정답 ①
비지도 신경망으로 고차원 데이터를 이해하기 쉬운 저차원의 뉴런으로 정렬해 지도 형태로 보여주는 알고리즘은 SOM(자기조직화지도)입니다. 입력층과 2차원 격자 형태의 경쟁층으로 이루어지고 차원 축소와 군집화를 함께 수행합니다. DBSCAN은 밀도 기반 군집, PCA는 선형 차원 축소입니다. 시험 포인트: SOM = 비지도 신경망·입력층+경쟁층(2층)·차원 축소와 군집화 동시 수행
문제 23
단원 통계 분석
다음의 설명에 해당 하는 것은 무엇인가? 공분산행렬 또는 상관계수 행렬을 사용해 모든 변수들을 가장 잘 설명하는 변수를 찾는 방법으로, 상관관계가 있는 변수들을 선형 결합에 의해 상관관계가 없는 새로운 변수를 만들고 분산을 극대화하는 변수로 축약하는 방법으로 새로운 변수들은 변수들의 선형결합으로 이루어져 있다
①요인 분석
②회귀 분석
③주성분 분석
④다차원 척도
정답 · 해설 보기
정답 ③
공분산행렬이나 상관계수 행렬을 사용해 모든 변수를 가장 잘 설명하는 주성분을 찾고, 상관관계가 있는 변수들을 선형결합해 상관관계가 없는 새 변수로 만들며 분산을 극대화하는 방법은 주성분 분석입니다. 새 변수(주성분)는 원래 변수들의 선형결합으로 이루어집니다. 시험 포인트: 주성분 분석(PCA) = 상관된 변수를 선형결합해 서로 무상관한 주성분으로 축약, 분산 극대화
문제 24
단원 통계 분석
다음 중 확률 및 확률분포에 관한 설명으로 틀린 것은?
①(사건 A가 일어나는 경우의 수)/(일어날 수 있는 모든 경우의 수)를 P(A)라 할 때 이를 A의 수학적 확률이라 한다.
②한 사건 A가 일어날 확률을 P(A)라 할 때 N번의 반복시행에서 사건 A가 일어난 횟수를 R이라하면, 상대도수 R/N은 N이 커짐에 따라 확률 P(A)에 가까워짐을 알 수 있다. P(A)를 사건 A의 통계적 확률이라 한다.
③두 사건 A,B가 독립일 때 사건 B의 확률은 A가 일어났다는 가정 하에서의 B의 조건부 확률과는 다르다.
④표본공간에서 임의의 사건 A가 일어날 확률 P(A)는 항상 0과 1사이에 있다.
정답 · 해설 보기
정답 ③
두 사건이 독립이면 한 사건의 발생이 다른 사건의 확률을 바꾸지 않으므로 P(B|A)=P(B)입니다. 즉 B의 확률은 A가 일어났다는 가정에서의 조건부 확률과 같습니다. 그래서 다르다는 설명이 틀렸습니다. 시험 포인트: 독립사건 P(B|A) = P(B), 조건부확률 P(A|B) = P(A∩B)/P(B)
문제 25
단원 통계 분석
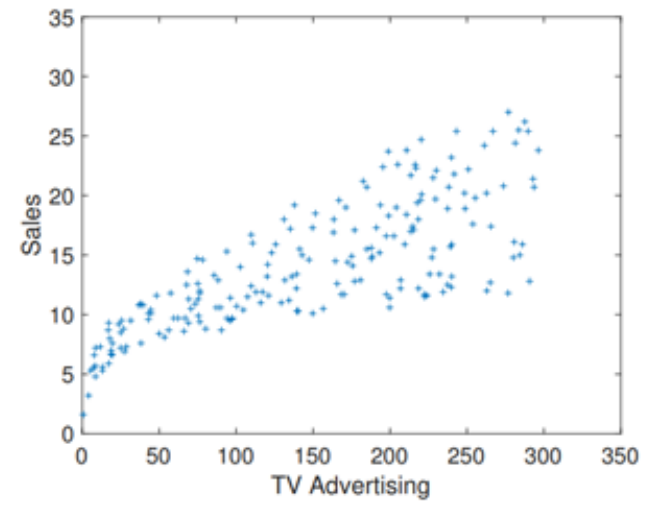
다음은 TV 광고수에 따른 Sales에 대한 산점도이다. 이에 대한 설명으로 알맞지 않은 것은?
①TV 광고가 증가할 수록 Sales 도 증가하는 경향이 있다.
②TV 광고와 Sales는 양의 상관관계를 가진다.
③TV 광고가 증가할수록 Sales의 분산은 동일하다.
④Sales를 설명하기 위해 TV 광고를 독립변수로 하는 단순선형회귀모델은 적절하다.
정답 · 해설 보기
정답 ③
산점도에서 TV 광고가 늘수록 Sales도 늘어나는 양의 상관관계가 보입니다. 다만 TV 광고가 증가함에 따라 점들의 퍼짐(분산)도 함께 커지므로 Sales의 분산이 동일하다는 설명은 알맞지 않습니다. TV 광고와 Sales의 관계를 설명하는 데 단순선형회귀모델을 쓰는 것은 적절합니다. 시험 포인트: 산점도에서 X가 커질수록 점의 퍼짐(분산)이 커지면 분산이 동일하지 않다
문제 26
단원 통계 분석
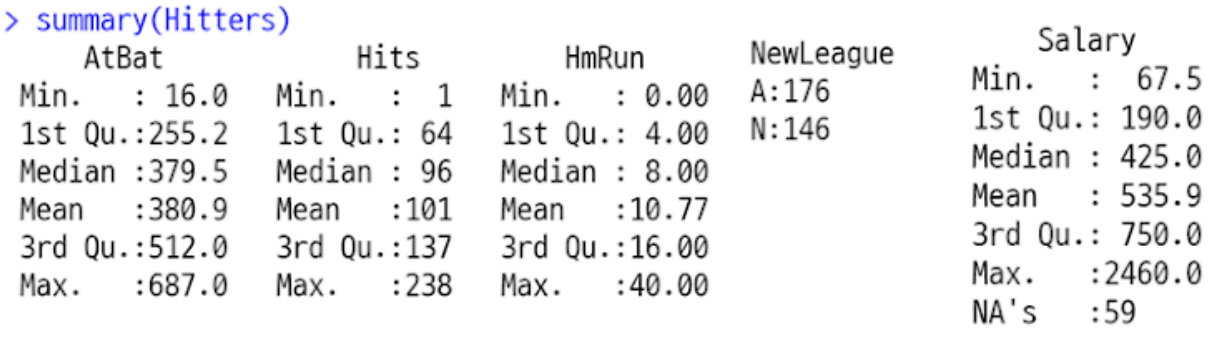
Hitters dataset의 일부이다. 다음 설명 중 적절하지 않은 것은?
①Salary 변수 분포는 왼쪽꼬리가 긴 분포를 가진다.
②NewLeague 변수는 범주형 자료이다.
③Hits 변수에는 결측값이 없음을 알 수 있다.
④HmRun 변수의 최대값은 40이다.
정답 · 해설 보기
정답 ①
Salary는 평균(535.9)이 중앙값(425.0)보다 커서 오른쪽으로 꼬리가 긴 분포입니다. 따라서 왼쪽 꼬리가 길다는 설명이 부적절합니다. NewLeague는 A와 N으로 구분되는 범주형 변수이고, Hits에는 NA가 없으며, HmRun의 최댓값은 40입니다. 시험 포인트: 평균 > 중앙값 → 오른쪽 꼬리가 긴 분포, 평균 < 중앙값 → 왼쪽 꼬리가 긴 분포
문제 27
단원 통계 분석
모집단의 크기가 비교적 작을 때 주로 사용되며 한번 추출된 표본의 재추출될 수 있는 표본 추출 방법은 무엇인가?
①복원추출법
②층화추출법
③군집추출법
④계층추출법
정답 · 해설 보기
정답 ①
모집단의 크기가 비교적 작을 때 주로 쓰고 한 번 추출된 표본이 다시 추출될 수 있는 방법은 복원추출법입니다. 붓스트랩이 대표적인 복원추출법입니다. 층화추출, 군집추출, 계통추출은 모집단을 나누거나 간격을 두고 뽑는 방법으로 복원추출법과 구분됩니다. 시험 포인트: 복원추출 = 한 번 뽑은 표본을 다시 뽑을 수 있음(붓스트랩)
문제 28
단원 R·데이터 전처리
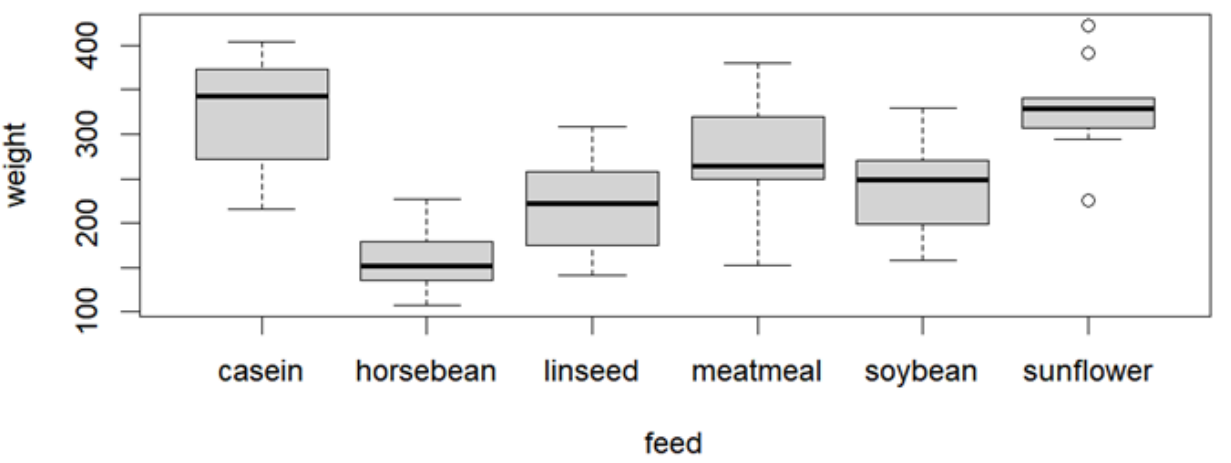
다음 닭 사료의 종류(feed)와 닭의 성장에 대한 boxplot결과이다. 옳지 않은 것은?
①이상치가 존재하지 않는 것을 알 수 있다
②casein의 경우 horsebean 보다 중위수가 크다
③soybean의 경우 meatmeal 보다 최소값은 크고 최대값은 작다.
④horsebean 사료를 먹은 닭의 무게가 가장 작은 쪽에 분포해 있다
정답 · 해설 보기
정답 ①
상자그림에서 sunflower 쪽에 동그라미로 표시된 점이 있어 이상치가 존재합니다. 따라서 이상치가 존재하지 않는다는 설명이 옳지 않습니다. casein의 중위수는 horsebean보다 크고, soybean은 meatmeal보다 최솟값은 크고 최댓값은 작으며, horsebean은 무게가 가장 작은 쪽에 분포합니다. 시험 포인트: 상자그림에서 수염 밖에 따로 찍힌 점 = 이상치(sunflower에 존재)
문제 29
단원 통계 분석
자료의 척도에 대한 설명으로 부적절한 것은?
①명목척도 : 단순히 측정 대상의 특성을 분류하거나 확인하기 위한 목적으로 사용된다.
②서열척도 : 대소 또는 높고 낮음 등의 순위만 제공할 뿐 양적인 비교는 할 수 없다.
③등간척도 : 사칙연산이 가능하다.
④비율척도 : 절대 0점이 존재하여 측정값 사이의 비율 계산이 가능한 척도이다.
정답 · 해설 보기
정답 ③
등간척도는 순위를 부여하되 순위 사이 간격이 동일해 양적 비교(덧셈, 뺄셈)는 가능하지만 절대 0점이 없어 곱셈·나눗셈 같은 비율 계산은 할 수 없습니다. 그래서 사칙연산이 가능하다는 설명이 부적절합니다. 사칙연산까지 가능한 것은 절대 0점이 있는 비율척도입니다. 시험 포인트: 등간척도 = 덧셈·뺄셈 가능, 절대 0 없음 / 비율척도 = 사칙연산 가능, 절대 0 있음
문제 30
단원 정형 데이터 마이닝
다음 연관 분석에 대한 설명 중 잘못된 것은?
①비목적성 분석 기법으로 계산이 간편하다.
②대표적인 알고리즘으로 Aprior가 있다.
③조건 반응으로 표현되는 연관분석의 결과를 이해하기 쉽다.
④품목 수가 증가해도 분석에 필요한 계산이 늘어나지 않는다.
정답 · 해설 보기
정답 ④
연관분석은 품목 수가 늘어나면 분석에 필요한 계산이 기하급수적으로 늘어나는 단점이 있습니다. 그래서 품목 수가 증가해도 계산이 늘어나지 않는다는 설명이 잘못되었습니다. 비목적성 분석 기법으로 계산이 간편하고, 대표 알고리즘은 Apriori이며, 조건-반응 형태의 결과를 이해하기 쉬운 것은 장점입니다. 시험 포인트: 연관분석 장점 = 비목적성·조건-결과로 이해 쉬움, 단점 = 품목 수 증가 시 계산량 기하급수적 증가
문제 31
단원 정형 데이터 마이닝
데이터 분할에 대한 설명 중 틀린 것은?
①데이터마이닝 적용 후 결과의 신빙성 검증을 위해 데이터를 학습, 검증, 테스트 데이터로 나누어 사용한다.
②검증용 데이터는 모델 성능 평가에 사용한다.
③테스트용 데이터와 학습 데이터는 섞여서는 안된다.
④검증용 데이터는 학습 단계에서 사용된다.
정답 · 해설 보기
정답 ②
데이터를 학습, 검증, 테스트 데이터로 나누어 쓰며, 검증용 데이터는 학습 단계에서 과적합 여부 확인이나 조기 종료 같은 중간 점검에 쓰입니다. 모델의 최종 성능 평가는 학습이 끝난 뒤 테스트용 데이터로 하므로 검증용 데이터를 모델 성능 평가에 쓴다는 설명이 틀렸습니다. 테스트 데이터와 학습 데이터는 섞이면 안 됩니다. 시험 포인트: 학습용 = 학습, 검증용 = 학습 중 성능 확인(과적합 점검), 테스트용 = 학습 후 최종 성능 평가
문제 32
단원 통계 분석
다음 표준오차에 대한 설명 중 틀린 것은?
①표본평균이 모평균과 얼마나 떨어져 있는가를 나타낸다.
②표준오차는 σ/√n 로 구한다
③표준오차 95%는 신뢰구간에 모수의 참값이 포함되어 있음을 나타낸다.
④더 작은 표준 오차는 추정치가 모집단 파라미터를 더 정확하게 반영한다는 것을 나타낸다.
정답 · 해설 보기
정답 ③
표준오차는 표본평균이 모평균과 얼마나 떨어져 있는지를 나타내며 σ/√n으로 구하고 n이 클수록 작아집니다. 더 작은 표준오차는 추정치가 모집단 모수를 더 정확하게 반영함을 뜻합니다. 신뢰구간에 모수의 참값이 포함됨을 나타내는 것은 표준오차가 아니라 신뢰수준(95%)이므로 그 설명이 틀렸습니다. 시험 포인트: 표준오차 = σ/√n(n이 클수록 작음), 신뢰수준 95% = 반복 추출 시 95%가 모수를 포함
문제 33
단원 정형 데이터 마이닝
아래의 불순도 측정 결과를 사용해서 구한 지니 지수는 얼마인가? ● ● ◆ ● ●
①0.5
②0.32
③0.48
④0.38
정답 · 해설 보기
정답 ②
지니지수는 1−Σ(범주별 비율)²로 구합니다. 5개 중 동그라미 4개(4/5), 다이아몬드 1개(1/5)이므로 1−((4/5)²+(1/5)²)=1−(16/25+1/25)=8/25=0.32입니다. 시험 포인트: 지니지수 = 1 − Σ pᵢ²
문제 34
단원 정형 데이터 마이닝
어떤 슈퍼마켓 고객 6명의 장바구니별 구입품목이 다음과 같다고 하자, 연관 규칙(콜라 -> 맥주)의 지지도는? 거래번호 1: 소주, 콜라, 맥주 거래번호 2: 소주, 콜라, 와인 거래번호 3: 소주, 주스 거래번호 4: 콜라, 맥주 거래번호 5: 소주, 콜라, 맥주, 와인 거래번호 6: 주스
①0.6
②0.4
③0.5
④0.3
정답 · 해설 보기
정답 ③
지지도는 전체 거래 중 두 품목을 동시에 포함한 거래의 비율입니다. 콜라와 맥주가 함께 있는 거래는 1, 4, 5번 세 건이므로 3/6=0.5입니다. 시험 포인트: 지지도(A→B) = A와 B를 모두 포함한 거래 수 ÷ 전체 거래 수
문제 35
단원 정형 데이터 마이닝
다음의 품목/거래량 표를 사용하여 연관 규칙(딸기→사과)의 향상도는 무엇인가? 딸기, 사과, 포도: 100 딸기, 포도: 400 사과, 포도, 바나나: 150 사과, 딸기, 바나나: 200 포도, 바나나: 150
①0.3
②0.3/(0.7*0.45)
③0.3/0.7
④0.3/(0.7 + 0.45)
정답 · 해설 보기
정답 ②
향상도는 P(B|A)/P(B)=P(A∩B)/(P(A)×P(B))입니다. 전체 거래량 1,000 중 딸기 포함 700(0.7), 사과 포함 450(0.45), 딸기와 사과를 함께 포함 300(0.3)이므로 향상도는 0.3/(0.7×0.45)입니다. 시험 포인트: 향상도 = P(A∩B) ÷ (P(A)×P(B)), 1보다 크면 양의 연관
문제 36
단원 정형 데이터 마이닝
다음 설명에 해당되는 앙상블 기법은? 여러 개의 붓스트랩 자료를 생성하고 각 붓스트랩 자료에 예측 모형을 만든 후 결합하여 최종 예측 모형을 만드는 방법이다.
①배깅(Bagging)
②Voting
③Boosting
④Stacking
정답 · 해설 보기
정답 ①
여러 개의 붓스트랩 자료를 만들고 각 자료에 예측 모형을 만든 뒤 결합해 최종 모형을 만드는 앙상블 기법은 배깅입니다. 보팅은 서로 다른 모형의 결과를 집계해 많은 표를 받은 것을 답으로 하고, 부스팅은 분류가 잘못된 데이터에 더 큰 가중치를 주어 순차적으로 학습하며, 스태킹은 여러 모형의 예측 결과를 다시 학습 데이터로 씁니다. 시험 포인트: 배깅 = 붓스트랩 + 결합, 보팅 = 다수결, 부스팅 = 오분류 가중치, 스태킹 = 예측 결과 재학습
문제 37
단원 정형 데이터 마이닝
군집분석 관련 설명으로 틀린 것은?
①계층적 군집분석은 사전에 군집 수 k를 설정할 필요가 없는 탐색적 모형이다.
②집단간 이질화, 집단내 동질화 모두 낮은 것을 군집으로 선택한다.
③K-means 군집은 잡음이나 이상값에 영향을 받기 쉽다.
④군집분석은 비지도학습이다.
정답 · 해설 보기
정답 ②
군집분석은 집단 간 이질성과 집단 내 동질성이 모두 높은 것을 군집으로 선택합니다. 모두 낮은 것을 선택한다는 설명이 틀렸습니다. 계층적 군집분석은 군집 수를 미리 정하지 않는 탐색적 모형이고, K-means는 잡음과 이상값에 영향을 받기 쉬우며, 군집분석은 비지도 학습입니다. 시험 포인트: 좋은 군집 = 집단 간 이질성 높음 + 집단 내 동질성 높음
문제 38
단원 통계 분석
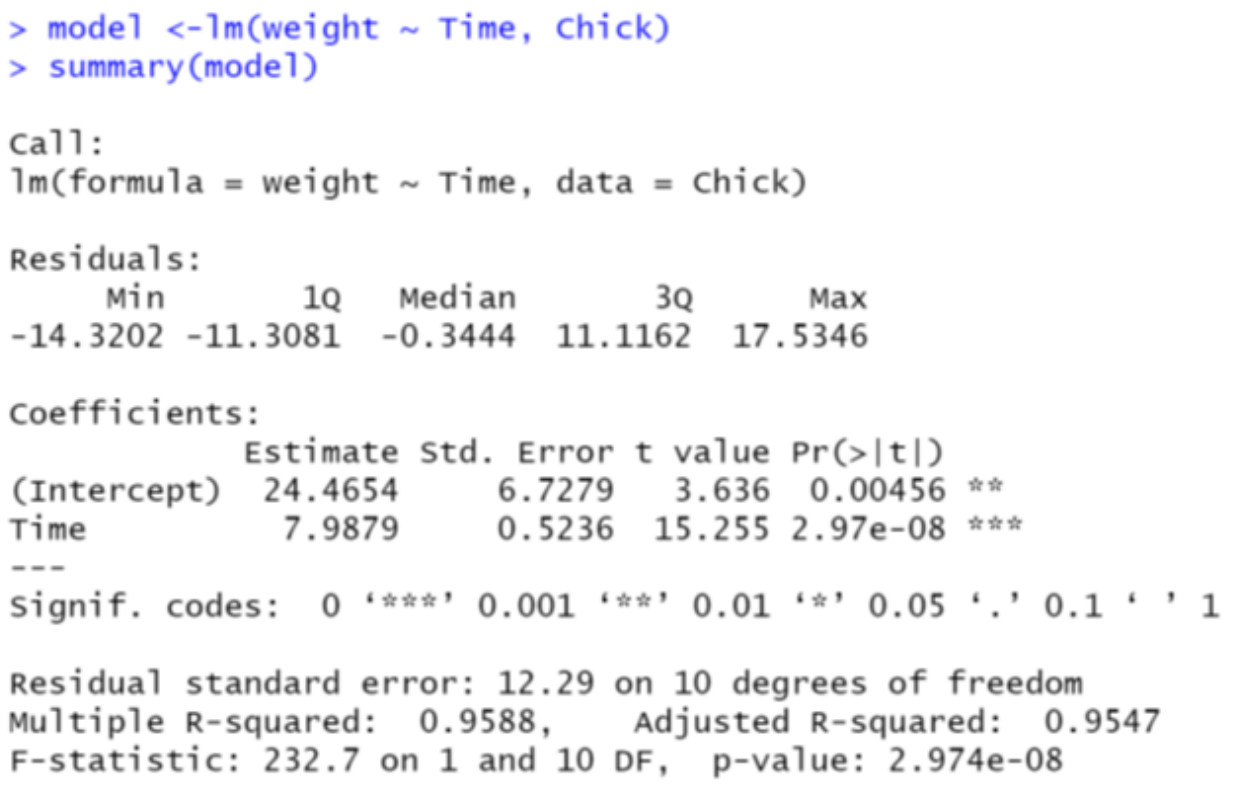
다음 회귀분석의 결과 해석으로 틀린 것은?
①결정계수는 0.9588이다.
②5% 유의수준에서 모형은 통계적으로 유의미 하다.
③Time이 1단위 증가하면 Weight가 평균적으로 8.8 증가한다.
④추정된 회귀식은 weight = 24.4654 + 7.9879 * Time 이다.
정답 · 해설 보기
정답 ③
추정된 회귀식은 weight = 24.4654 + 7.9879 × Time이므로 Time이 1단위 늘면 weight가 평균 7.9879 증가합니다. 따라서 8.8 증가한다는 설명이 틀렸습니다. 결정계수는 0.9588이고, F통계량의 p-value가 2.974e-08이라 5% 수준에서 모형이 유의합니다. 시험 포인트: 회귀계수 = 독립변수 1 증가 시 종속변수의 평균 변화량 (여기서는 7.9879)
문제 39
단원 통계 분석
독립변수간 상관관계가 높아 많은 문제점을 발생하는 현상으로 회귀계수의 분산을 증가시켜 불안정하고 해석하기 어렵게 만들게 되는 것을 다중공선성이라고 한다. 이것의 해결 방법으로 사용할 수 있는 것은?
①주성분 분석
②교차 분석
③오차 분석
④연관 분석
정답 · 해설 보기
정답 ①
다중공선성은 독립변수끼리 상관이 높아 회귀계수의 분산이 커지고 해석이 어려워지는 현상입니다. 상관된 변수들을 서로 무상관한 주성분으로 바꾸는 주성분 분석으로 해결할 수 있습니다. 교차 분석, 오차 분석, 연관 분석은 다중공선성 해결 방법이 아닙니다. 시험 포인트: 다중공선성 = 독립변수 간 높은 상관, 해결 = 변수 제거 또는 주성분 분석(PCA)
문제 44
단원 통계 분석
시계열분석에서 시계열의 수준과 분산에 체계적인 변화가 없고, 주기적 변동이 없다는 것으로 미래는 확률적으로 과거와 동일하다는 것을 의미하는 용어는?
정답 · 해설 보기
정답 정상성 (단답형)
정상성(stationarity)은 시계열의 평균(수준)과 분산에 체계적인 변화가 없고 주기적 변동도 없어서 미래가 확률적으로 과거와 같다는 성질입니다. 추세·계절성·불규칙 변동은 시계열을 분해할 때 나오는 구성 요소이며, 정상 시계열에는 이런 체계적 변동이 없습니다. 비정상 시계열은 차분이나 변환으로 정상 시계열로 바꿔서 분석합니다. 시험 포인트: 정상 시계열 = 평균·분산 일정 + 추세·주기성 없음, 비정상 시계열은 차분으로 정상화
다음 빈칸에 알맞은 단어는 무엇인가? 완전 연결법이라고도 하며, 두 군집 사이의 거리를 군집에서 하나씩 관측 값을 뽑았을 때 나타날 수 있는 거리의 ( )을 측정한다.
정답 · 해설 보기
정답 최댓값 (단답형)
완전 연결법(최장 연결법)은 두 군집에서 관측값을 하나씩 뽑았을 때 나타날 수 있는 거리 중 최댓값으로 군집 간 거리를 측정합니다. 최단 연결법(단일 연결법)은 같은 방식으로 최솟값을, 평균 연결법은 평균을 사용합니다. 시험 포인트: 최단(단일) 연결법 = 최솟값, 최장(완전) 연결법 = 최댓값, 평균 연결법 = 평균
문제 47
단원 시계열·차원 축소
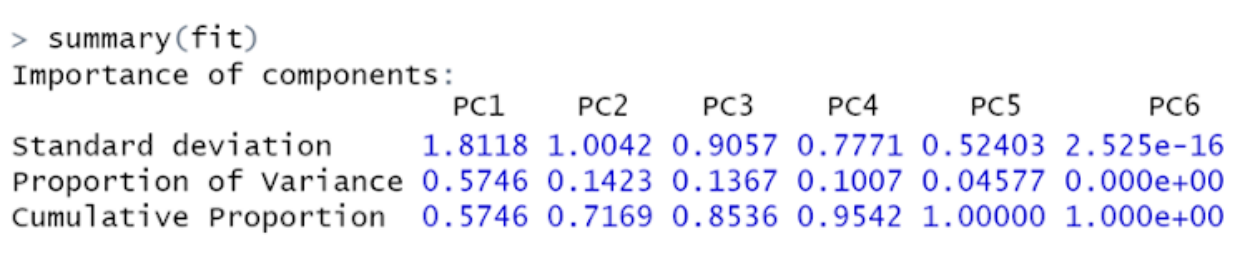
다음 주성분 분석 결과에서 주성분 1개를 사용했을 때 분산을 구하시오. (%로 표기, 소수점 둘째 자리에서 반올림)
정답 · 해설 보기
정답 57.5% (단답형)
주성분 1개를 사용했을 때 설명되는 분산은 PC1의 Proportion of Variance를 보면 됩니다. PC1은 0.5746이므로 %로 바꾸면 57.46%이고, 소수점 둘째 자리에서 반올림하면 57.5%입니다. Cumulative Proportion은 PC1부터 해당 주성분까지 누적한 분산 비율입니다. 시험 포인트: 주성분 k개 사용 시 설명 분산 = Cumulative Proportion (1개일 때는 PC1의 Proportion of Variance와 같음)
문제 48
단원 정형 데이터 마이닝
생물학적 진화 과정을 모방하여 최적화 및 검색 문제를 해결하는데 사용되는 계산 알고리즘으로 다양한 해를 탐색하고 선택, 교차, 변이와 같은 유전 연산을 통해 최적의 해를 찾아내는데 효과적인 알고리즘은?
정답 · 해설 보기
정답 유전 알고리즘 (단답형)
생물학적 진화 과정을 모방해 선택, 교차, 변이 같은 유전 연산으로 다양한 해를 탐색하고 최적해를 찾아가는 알고리즘은 유전 알고리즘입니다. 담금질 기법은 금속의 냉각 과정을 모방한 최적화 기법, 경사하강법은 기울기를 따라 손실을 줄여 가는 방법, 그리디 알고리즘은 매 순간 최선의 선택을 하는 방법입니다. 시험 포인트: 유전 알고리즘 = 진화 모방, 선택·교차·변이 연산으로 최적해 탐색
문제 49
단원 통계 분석
모집단을 먼저 서로 겹치지 않는 여러 개의 층으로 분할한 후, 각 층에서 단순 임의 추출법에 따라 배정된 표본을 추출하는 방법?
정답 · 해설 보기
정답 층화추출법 (단답형)
모집단을 서로 겹치지 않는 여러 층으로 나누고 각 층에서 단순 임의 추출로 표본을 뽑는 방법은 층화 추출법입니다. 단순 임의 추출법은 모든 개체가 같은 확률로 뽑히는 방법이고, 계통 추출법은 일련번호를 붙여 일정 간격으로 뽑는 방법이며, 군집 추출법은 모집단을 여러 집단으로 나눈 뒤 일부 집단을 통째로 뽑는 방법입니다. 시험 포인트: 층화 = 층별로 임의 추출, 군집 = 집단 통째로 선택, 계통 = 일정 간격 추출, 단순 임의 = 동일 확률
문제 50
단원 정형 데이터 마이닝
신경망 노드 중 무작위로 노드를 선정하여 다수의 모형을 구성하고 학습한 뒤 각 모형의 결과를 결합해 분류 및 예측하는 기법을 무엇이라고 하는가?
①Mini-Batch
②Bagging
③Drop-out
④AdaBoost
정답 · 해설 보기
정답 ③
드롭아웃(Drop-out)은 신경망을 학습할 때 노드의 일부를 무작위로 골라 그 회차의 학습에서 제외하는 기법입니다. 매번 다른 노드로 이루어진 부분 신경망을 학습하게 되어, 서로 다른 여러 모형을 만들어 결과를 결합하는 앙상블과 비슷한 효과를 내고 과대적합을 줄입니다. 배깅은 노드가 아니라 붓스트랩 표본을 무작위로 뽑는 방식이고, 미니배치는 학습 데이터를 일정 크기로 나누어 학습하는 방법이며, AdaBoost는 이전 모델이 잘못 분류한 표본에 가중치를 주며 순차적으로 학습합니다. [출제 논란] 출제 오류 안내: 원본 정답키는 AdaBoost였지만, 발문은 노드를 무작위로 골라 여러 부분 모형을 학습하고 결합하는 드롭아웃의 정의와 맞습니다. AdaBoost는 노드가 아니라 잘못 분류된 표본에 가중치를 주는 부스팅 기법이라 패스뱅크는 드롭아웃을 정답으로 수록했습니다. 시험 포인트: Drop-out = 학습 중 노드를 무작위로 제외(과대적합 방지·앙상블 효과), 배깅 = 붓스트랩 표본, AdaBoost = 오분류 가중치 순차 학습