ADsP 데이터분석 준전문가 33회 필기 기출문제 50문항입니다. 먼저 아래 출제 분석으로 회차의 난이도와 단원 구성을 확인한 뒤, 문제마다 정답 · 해설 보기를 눌러 정답과 해설을 확인하세요.
33회 출제 분석
이 회차는 아직 회원 풀이 기록이 충분하지 않아 정답률을 표시하지 않습니다. 아래는 과목 구성과 문항 정보입니다.
많이 나온 단원은 데이터 이해: 빅데이터의 가치와 위기 4문항, 데이터와 정보 3문항 / 데이터 분석 기획: 마스터 플랜·거버넌스 4문항, 분석 방법론 2문항 / 데이터 분석: 정형 데이터 마이닝 15문항, 통계 분석 9문항입니다.
과목
문항
단원 분포
데이터 이해
10
빅데이터의 가치와 위기 4 · 데이터와 정보 3 · 데이터베이스 활용 2 · 데이터 사이언스·인재 1
데이터 분석 기획
10
마스터 플랜·거버넌스 4 · 분석 방법론 2 · 분석 과제 발굴 2 · 분석 기획 기본 2
데이터 분석
30
정형 데이터 마이닝 15 · 통계 분석 9 · 시계열·차원 축소 4 · R·데이터 전처리 2
회원 정답률은 패스뱅크 회원이 문제풀이·모의고사에서 실제로 푼 기록을 집계한 값입니다. 문제 하나는 풀이 10건, 과목·단원·회차 묶음은 50건 이상일 때만 표시합니다. 단원은 문제 문장의 핵심 용어로 패스뱅크가 자동 분류한 것이라 공식 출제 기준표의 단원과 다를 수 있습니다.
데이터 이해
문제 1
단원 데이터 사이언스·인재
데이터 사이언티스트가 갖추어야 하는 역량 중 소프트 스킬에 해당하지 않는 것은?
①통찰력 있는 분석
②다분야 간 협력
③설득력 있는 전달
④빅데이터 이론적 지식
정답 · 해설 보기
정답 ④
데이터 사이언티스트의 역량은 하드 스킬과 소프트 스킬로 나뉩니다. 하드 스킬은 빅데이터에 대한 이론적 지식과 분석 기술에 대한 숙련처럼 배워서 쌓는 기술입니다. 소프트 스킬은 통찰력 있는 분석(창의적 사고, 호기심), 설득력 있는 전달(스토리텔링, 시각화), 다분야 간 협력(커뮤니케이션)입니다. 그래서 빅데이터 이론적 지식은 소프트 스킬이 아니라 하드 스킬입니다. 시험 포인트: 하드 스킬 = 이론 지식·분석 기술, 소프트 스킬 = 통찰력·설득력 있는 전달·협력
문제 2
단원 데이터와 정보
데이터 크기를 작은 것부터 큰 것 순서로 올바르게 나열한 것은?
①PB < EB < ZB < YB
②YB < ZB < EB < PB
③PB < YB < EB < ZB
④PB < ZB < EB < YB
정답 · 해설 보기
정답 ①
데이터 크기 단위는 KB, MB, GB, TB, PB, EB, ZB, YB 순으로 커지며 한 단계마다 약 1,024배씩 증가합니다. 따라서 PB < EB < ZB < YB가 올바른 순서입니다. YB부터 거꾸로 나열한 것은 큰 것부터 작은 순서이고, PB 다음에 YB나 ZB를 바로 놓은 나열은 EB·ZB·YB의 순서가 뒤섞여 틀렸습니다. 시험 포인트: KB < MB < GB < TB < PB < EB < ZB < YB
문제 3
단원 데이터베이스 활용
데이터베이스의 특징이 아닌 것은?
①USB 등 컴퓨터가 접근할 수 있는 저장 매체에 저장할 수 있다
②데이터는 공동으로 이용 된다
③데이터가 중복되어 있지 않다
④정형 데이터만 저장할 수 있다
정답 · 해설 보기
정답 ④
데이터베이스는 통합된 데이터(중복 없음), 저장된 데이터(컴퓨터가 접근 가능한 저장 매체에 저장), 공용 데이터(여러 사용자가 공동 이용), 변화되는 데이터(삽입·삭제·갱신으로 계속 변함)라는 특징을 가집니다. 데이터베이스에는 정형 데이터뿐 아니라 이미지·문서 같은 비정형 데이터나 XML·JSON 같은 반정형 데이터도 저장할 수 있으므로 정형 데이터만 저장한다는 설명이 틀렸습니다. 시험 포인트: DB 특징 = 통합·저장·공용·변화되는 데이터
문제 4
단원 빅데이터의 가치와 위기
미래의 빅데이터 관점에서 볼 때 사물인터넷(IoT)과 가장 관련이 큰 것은?
①모든 사물의 데이터화
②모든 사물의 독립화
③모든 사물의 그래픽화
④모든 사물의 정형화
정답 · 해설 보기
정답 ①
사물인터넷(IoT)은 사물에 센서와 통신 기능을 붙여 사물이 스스로 데이터를 만들고 주고받게 하는 기술입니다. 미래의 빅데이터 관점에서 IoT는 모든 사물의 데이터화(datafication)와 가장 관련이 큽니다. 사물의 독립화, 그래픽화, 정형화는 IoT가 지향하는 연결과 데이터 생성과는 거리가 먼 표현입니다. 시험 포인트: 미래 빅데이터의 변화 = 모든 것의 데이터화, IoT = 사물의 데이터화
문제 5
단원 빅데이터의 가치와 위기
빅데이터가 가져온 변화로 맞지 않은 것은?
①서비스 산업이 확대되고 제조업의 생산성이 감소되었다
②빅데이터 시대에는 데이터 획득비용이 기하급수적으로 감소하고 모든 곳에서 데이터가 넘쳐나 사용자 전수조사가 가능해 졌다
③가능한 한 많은 데이터를 모으고 그 데이터를 다양한 방식으로 조합해 숨은 정보를 찾아낸다
④데이터의 질보다 양을 강조하게 되었다
정답 · 해설 보기
정답 ①
빅데이터는 데이터 획득 비용을 크게 낮춰 전수조사를 가능하게 했고, 가능한 한 많은 데이터를 모아 다양하게 조합해 숨은 정보를 찾는 방식으로 분석을 바꾸었으며, 데이터의 질보다 양을 중시하게 했습니다. 산업 측면에서는 서비스 산업 확대와 함께 제조업의 생산성도 높아졌습니다. 그래서 제조업 생산성이 감소했다는 설명이 틀렸습니다. 시험 포인트: 빅데이터의 변화 = 전수조사 가능, 질보다 양, 서비스 확대·제조업 생산성 향상
문제 6
단원 빅데이터의 가치와 위기
다음 중 빅데이터 위기 요인과 해결 방안을 잘못 연결된 것을 고르시오.
가. 사생활 침해 -> 동의제를 책임제로 전환 나. 책임원칙의 훼손 -> 알고리즘 허용 다. 데이터의 오용 -> 결과 기반 책임 원칙
①가, 나
②가, 다
③나, 다
④가, 나, 다
정답 · 해설 보기
정답 ③
빅데이터 위기 요인과 통제 방안은 사생활 침해 → 동의제에서 책임제로 전환, 책임원칙의 훼손 → 결과 기반 책임 원칙 고수, 데이터의 오용 → 알고리즘 허용(알고리즈미스트 활용)으로 짝지어집니다. 가는 올바르게 연결되었지만, 나와 다는 해결 방안이 서로 뒤바뀌어 잘못 연결되었습니다. 그래서 나, 다가 정답입니다. 시험 포인트: 사생활 침해-책임제, 책임원칙 훼손-결과 기반 책임, 데이터 오용-알고리즘 허용
문제 7
단원 데이터베이스 활용
데이터 NoSQL 저장방식과 관련이 없는 도구는?
①MongoDB
②HBase
③Redis
④MySQL
정답 · 해설 보기
정답 ④
NoSQL은 관계형 모델의 고정 스키마와 조인 대신 키-값, 문서, 컬럼 패밀리 같은 방식으로 데이터를 저장하는 비관계형 데이터베이스입니다. MongoDB는 문서형, HBase는 컬럼 기반, Redis는 키-값 저장소로 모두 NoSQL에 속합니다. MySQL은 SQL을 사용하는 대표적인 관계형 데이터베이스(RDBMS)이므로 NoSQL 저장 방식과 관련이 없습니다. 시험 포인트: NoSQL = MongoDB·HBase·Redis·Cassandra, MySQL·Oracle = RDBMS
문제 8
단원 빅데이터의 가치와 위기
빅데이터 특징 중 올바르지 않는 것은?
①비즈니스 상황에서는 인과관계를 모르고 상관관계 분석만으로 충분한 경우가 많다
②사전처리에서 사후처리 시대로 변화하였고, 사전처리의 대표적인 예로는 표준화된 문서 포맷을 들 수 있다
③표본조사의 중요성이 높아졌다
④데이터 수가 증가함에 따라 몇 개의 오류데이터가 대세에 영향을 주지 못하는 경향이 증가하고 있다
정답 · 해설 보기
정답 ③
빅데이터 시대의 변화는 사전처리에서 사후처리로, 표본조사에서 전수조사로, 질보다 양으로, 인과관계에서 상관관계로의 이동입니다. 데이터가 많아지면 일부 오류 데이터가 전체 경향에 주는 영향이 줄어들고, 표준화된 문서 포맷은 사전처리의 예입니다. 데이터 수집 비용이 줄어 전수조사가 가능해졌으므로 표본조사의 중요성이 높아졌다는 설명이 틀렸습니다. 시험 포인트: 빅데이터 변화 = 사전→사후처리, 표본→전수조사, 질→양, 인과→상관
문제 41
단원 데이터와 정보
조직의 의사결정을 위한 데이터 집합체로 데이터 통합, 시계열성, 비소멸성 등의 특징을 가지고 있는 것은?
정답 · 해설 보기
정답 데이터웨어하우스 (단답형)
정답은 데이터웨어하우스(DW)입니다. 데이터웨어하우스는 조직의 의사결정을 지원하기 위해 여러 시스템의 데이터를 모아 둔 저장소로 주제 지향성, 통합성, 시계열성, 비휘발성(비소멸성)이 특징입니다. 데이터마트는 데이터웨어하우스 중 특정 부서나 주제에 맞춘 작은 단위의 저장소이고, 운영 데이터베이스는 일상 거래 처리를 위한 시스템이라 구별됩니다. 시험 포인트: DW 특징 = 주제 지향·통합·시계열·비휘발
문제 42
단원 데이터와 정보
다양한 유형의 데이터를 다루는 통계학과 마이닝을 넘어서는 학문, 데이터 공학, 수학, 통계학, 컴퓨터 공학 등 해당 분야의 전문 지식을 종합한 학문은?
정답 · 해설 보기
정답 데이터 사이언스 (단답형)
정답은 데이터 사이언스입니다. 데이터 사이언스는 정형·반정형·비정형 데이터를 모두 다루며 데이터 공학, 수학, 통계학, 컴퓨터 공학, 시각화, 해커 사고 등 여러 분야의 지식을 종합한 학문입니다. 통계학은 주로 정형 데이터를, 데이터 마이닝은 주로 분석 기법을 다루는 데 비해, 데이터 사이언스는 분석뿐 아니라 이를 구현하고 전달하는 과정까지 포함한다는 점이 다릅니다. 시험 포인트: 데이터 사이언스 = 통계학·데이터 마이닝보다 넓은 종합 학문
데이터 분석 기획
문제 9
단원 분석 방법론
빅데이터 분석 방법론에서 분석 기획 단계의 task로 적절하지 않은 것은?
①비즈니스 이해 및 범위 설정
②프로젝트 정의 및 계획 수립
③프로젝트 위험 계획 수립
④필요 데이터 정의
정답 · 해설 보기
정답 ④
빅데이터 분석 방법론의 분석 기획 단계에는 비즈니스 이해 및 범위 설정, 프로젝트 정의 및 계획 수립, 프로젝트 위험 계획 수립이라는 세 가지 태스크가 있습니다. 필요 데이터 정의는 다음 단계인 데이터 준비 단계에서 데이터 스토어 설계, 데이터 수집 및 정합성 점검과 함께 수행하는 태스크입니다. 그래서 분석 기획 단계의 태스크로 적절하지 않습니다. 시험 포인트: 분석 기획 = 범위 설정·프로젝트 정의·위험 계획, 데이터 준비 = 필요 데이터 정의
문제 10
단원 분석 방법론
빅데이터 분석방법론의 계층적 프로세스 모델에 대한 설명으로 적절하지 않는 것은?
①Task는 단계를 구성하는 단위 활동으로 input, output로 구성된 단위 프로세스이다
②Phase(단계)는 최상위 단계로 프로세스 그룹을 통하여 완성된 단계별 산출물을 생성한다.
③Step(스탭)은 마지막 계층으로 WBS(Work Breakdown Structure)의 워크패키지에 해당한다
④Phase, Task, Step 계층이 있다
정답 · 해설 보기
정답 ①
빅데이터 분석 방법론은 단계(Phase), 태스크(Task), 스텝(Step)의 3계층 프로세스로 구성됩니다. 단계는 최상위 계층으로 단계별 산출물을 만들고, 태스크는 단계를 구성하는 단위 활동으로 물리적·논리적 단위의 품질 검토 항목이 됩니다. 입력자료, 처리 및 도구, 출력자료로 구성된 단위 프로세스는 WBS의 워크패키지에 해당하는 스텝의 설명이므로 이를 태스크라고 한 설명이 틀렸습니다. 시험 포인트: Phase → Task(단위 활동) → Step(입력·처리·출력 단위 프로세스, WBS 워크패키지)
문제 11
단원 마스터 플랜·거버넌스
분석 과제 우선순위 선정 매트릭스에 관한 설명 중 가장 적절하지 않은 것은?
①시급성의 판단기준은 전략도 중요도와 비용범위에 따라 난이도는 분석수준과 복잡도 평가로 구분한다.
②데이터 분석 과제를 추진할 때 우선 고려해야 하는 요소는 전략도 중요도에 따른 시급성이 가장 중요한 요소이다.
③난이도는 해당 기업의 현 상황에 따라 조율할 수 있다.
④사분면 영역에서 가장 우선적인 분석 과제 적용이 필요한 영역은 3사분면 영역이다.
정답 · 해설 보기
정답 ①
우선순위 평가 매트릭스는 시급성과 난이도 두 축으로 과제를 배치합니다. 시급성은 전략적 중요도와 목표 가치(KPI)로 판단하고, 난이도는 데이터 획득·가공 비용 같은 비용 범위와 분석 수준·복잡도로 판단합니다. 비용 범위는 난이도의 기준이므로 시급성의 판단 기준을 전략적 중요도와 비용 범위라고 한 설명이 틀렸습니다. 시급성이 가장 중요한 요소이고 3사분면이 최우선이라는 설명은 옳습니다. 시험 포인트: 시급성 = 전략적 중요도·목표 가치, 난이도 = 비용·분석 수준
문제 12
단원 마스터 플랜·거버넌스
분석 마스터플랜 수립 시 우선 순위 고려사항에 해당하지 않는 것은 ?
①전략적 중요도
②비즈니스 성과 및 ROI
③실행 용이성
④데이터 필요 우선 순위
정답 · 해설 보기
정답 ④
분석 마스터플랜을 세울 때 우선순위는 전략적 중요도, 비즈니스 성과 및 ROI, 실행 용이성을 고려해 정하고, 적용 범위와 방식은 업무 내재화 적용 수준, 분석 데이터 적용 수준, 기술 적용 수준으로 검토합니다. 데이터 필요 우선순위는 이러한 우선순위 고려 요소에 포함되지 않습니다. 시험 포인트: 마스터플랜 우선순위 = 전략적 중요도·비즈니스 성과/ROI·실행 용이성
문제 13
단원 분석 과제 발굴
하향식 접근 방식의 순서로 올바른 것은?
(가) 문제탐색 단계 (나) 문제 정의 (다) 해결방안탐색 (라) 타당성 검토
①나–가–다–라
②가–나–다–라
③가–나–라–다
④나–가–라–다
정답 · 해설 보기
정답 ②
하향식 접근법은 문제가 주어진 상태에서 해법을 찾아가는 방식으로 문제 탐색 → 문제 정의 → 해결 방안 탐색 → 타당성 검토 순서로 진행합니다. 비즈니스 모델 캔버스 등으로 과제를 찾고, 이를 데이터 문제로 바꾸어 정의한 뒤, 해결 방안을 찾고 경제적·데이터적·기술적 타당성을 검토합니다. 그래서 가–나–다–라가 올바른 순서입니다. 시험 포인트: 하향식 = 문제 탐색 → 문제 정의 → 해결 방안 탐색 → 타당성 검토
문제 14
단원 분석 과제 발굴
다음 중 상향식 접근방식의 특징으로 적절하지 않은 것은?
①상향식 접근 방식의 데이터 분석은 지도학습 방법에 의해 수행된다
②문제의 정의 자체가 어려운 경우 사용하는 방식이다
③디자인 싱킹(Design Thinking)의 발산 단계에 해당한다.
④데이터를 기반으로 문제의 재정의 및 해결방안을 탐색하고 이를 지속적으로 개선하는 방식이다
정답 · 해설 보기
정답 ①
상향식 접근법은 문제 정의 자체가 어려울 때 데이터를 먼저 살펴보며 문제를 재정의하고 해결 방안을 찾아 지속적으로 개선하는 방식으로, 디자인 싱킹의 발산(Diverge) 단계에 해당합니다. 정답 레이블 없이 데이터의 패턴을 찾으므로 주로 비지도 학습 방법으로 수행됩니다. 그래서 지도 학습 방법으로 수행된다는 설명이 틀렸습니다. 시험 포인트: 상향식 = 비지도 학습·발산 단계, 하향식 = 수렴 단계
문제 15
단원 마스터 플랜·거버넌스
다음 중 ROI 관점에서의 분석 과제에 대한 우선순위 평가 기준에 대한 설명 중 적절하지 않은 것은?
①분석 난이도는 분석 준비도와 성숙도에 따라 해당 기업의 분석 수준을 파악하고 이를 바탕으로 결정된다
②시급성이 높고 난이도가 높은 분석 과제는 우선 순위 기준이 높다
③난이도에 우선 순위 기준을 놓으면 시급성 높고 난이도 쉬운 과제가 가장 먼저 수행되어야 한다
④시급성이 높고 난이도가 높은 분석과제는 경영진에 의해 조정 가능하다
정답 · 해설 보기
정답 ②
ROI 관점의 우선순위 평가는 시급성과 난이도로 판단하며, 난이도는 분석 준비도와 성숙도로 파악한 기업의 분석 수준에 따라 결정됩니다. 시급성이 높고 난이도가 높은 과제는 1사분면으로, 경영진이나 실무자의 의사결정에 따라 우선순위를 조정할 수 있는 영역이지 우선순위가 높은 영역이 아닙니다. 그래서 우선순위 기준이 높다는 설명이 틀렸습니다. 시험 포인트: 최우선 = 3사분면(시급성 높고 난이도 쉬움), 1사분면 = 조정 가능 영역
문제 16
단원 마스터 플랜·거버넌스
포트폴리오 사분면 분석을 통한 과제 우선순위를 선정하는 기법 중 분석 과제의 적용 우선순위를 '시급성'에 둔다면 결정해야 할 우선순위는?
세로축: 난이도(아래 Easy → 위 Difficult), 가로축: 시급성(왼쪽 현재 → 오른쪽 미래)
난이도 \ 시급성
현재
미래
Difficult
Ⅰ
Ⅱ
Easy
Ⅲ
Ⅳ
①Ⅲ-Ⅳ-Ⅱ
②Ⅰ-Ⅱ-Ⅲ
③Ⅱ-Ⅳ-Ⅰ
④Ⅲ-Ⅰ-Ⅱ
정답 · 해설 보기
정답 ①
포트폴리오 사분면에서 3사분면(현재 시급하고 난이도 쉬움)은 어떤 기준이든 가장 먼저 추진하고, 2사분면(미래·어려움)은 가장 나중입니다. 교재는 우선순위를 시급성에 둘 때 Ⅲ-Ⅳ-Ⅱ, 난이도에 둘 때 Ⅲ-Ⅰ-Ⅱ 순서로 정리합니다. 따라서 시급성 기준의 정답은 Ⅲ-Ⅳ-Ⅱ이고, Ⅲ-Ⅰ-Ⅱ는 난이도 기준의 순서라 혼동하기 쉽습니다. 시험 포인트: 시급성 기준 Ⅲ-Ⅳ-Ⅱ, 난이도 기준 Ⅲ-Ⅰ-Ⅱ
문제 43
단원 분석 기획 기본
다음은 어떤 분석 모델 프로세스에 관한 것인가?
반복을 통하여 점증적으로 개발하는 방법으로써 처음 시도하는 프로젝트에 적용이 용이하지만, 반복에 대한 관리체계를 효과적으로 갖추지 못한 경우 복잡도가 상승하여 프로젝트 진행이 어려울 수 있다.
정답 · 해설 보기
정답 나선형 모델 (단답형)
정답은 나선형 모델입니다. 나선형 모델은 반복을 통해 점증적으로 개발하는 방식으로, 처음 시도하는 프로젝트에 적용하기 쉽지만 반복 관리 체계가 부족하면 복잡도가 높아져 진행이 어려워질 수 있습니다. 폭포수 모델은 단계를 순차적으로 진행하는 하향식 방식이고, 프로토타입 모델은 사용자 요구를 빠르게 확인하는 시제품 중심의 상향식 방식이라 구별됩니다. 시험 포인트: 폭포수 = 순차, 프로토타입 = 시제품, 나선형 = 반복·점증 개발
문제 44
단원 분석 기획 기본
다음 중 빈 칸에 들어갈 올바른 용어는 무엇인가?
분석방법(how) \ 분석대상(what)
Known
Un-Known
Known
최적화(Optimization)
( )
Un-Known
솔루션(Solution)
발견(Discovery)
정답 · 해설 보기
정답 통찰 (단답형)
정답은 통찰(Insight)입니다. 분석 주제 유형은 분석 대상(what)과 분석 방법(how)의 인지 여부로 나뉩니다. 대상과 방법을 모두 알면 최적화, 대상은 알지만 방법을 모르면 솔루션, 방법은 알지만 대상을 모르면 통찰, 둘 다 모르면 발견입니다. 빈칸은 분석 방법은 Known이고 분석 대상은 Un-Known인 칸이므로 통찰이 들어갑니다. 시험 포인트: 최적화(둘 다 앎), 솔루션(대상만 앎), 통찰(방법만 앎), 발견(둘 다 모름)
데이터 분석
문제 17
단원 정형 데이터 마이닝
Accuracy와 Precision에 대한 설명으로 틀린 것은?
①Accuracy는 실제가 True 인 것 중 예측도 True인 것을 의미한다
②Precision은 예측이 True 인 것 중 실제도 True인 것을 의미한다
③Precision은 TP / (TP + FP)으로 구할 수 있다
④Accuracy는 (TP + TN) / (TP + FP + FN + TN)으로 구할 수 있다
정답 · 해설 보기
정답 ①
정확도(Accuracy)는 전체 데이터 중 올바르게 예측한 비율로 (TP+TN)/(TP+FP+FN+TN)이고, 정밀도(Precision)는 True로 예측한 것 중 실제 True인 비율로 TP/(TP+FP)입니다. 실제 True인 것 중 예측도 True인 비율은 재현율(Recall, 민감도)인 TP/(TP+FN)의 정의입니다. 그래서 이를 Accuracy의 정의라고 한 설명이 틀렸습니다. 시험 포인트: 정확도 = 전체 중 정답, 정밀도 = 예측 True 중 실제 True, 재현율 = 실제 True 중 예측 True
문제 18
단원 통계 분석
확률변수 X가 확률질량함수를 갖는 이산형 확률변수 인 경우 그 기댓값으로 옳은 것은?
①$E(x) = \sum x f(x)$
②$E(x) = \int x f(x)$
③$E(x) = E[(x-\mu)^2]$
④$E(x) = x^3 - x^2$
정답 · 해설 보기
정답 ①
이산형 확률변수의 기댓값은 각 값에 그 값이 나올 확률(확률질량함수)을 곱해 모두 더한 E(X)=Σx·f(x)입니다. 적분 ∫x·f(x)dx는 확률밀도함수를 갖는 연속형 확률변수의 기댓값입니다. E[(X−μ)²]는 기댓값이 아니라 분산의 정의이고, x³−x²는 기댓값과 관계없는 식입니다. 시험 포인트: 이산형 E(X)=Σx·f(x), 연속형 E(X)=∫x·f(x)dx, 분산 = E[(X−μ)²]
문제 19
단원 정형 데이터 마이닝
아래 오분류표를 이용하여 구한 F1 값은 얼마인가?
실제값 \ 예측치
TRUE
FALSE
합계
TRUE
200
300
500
FALSE
300
200
500
합계
500
500
1000
①0.5
②0.4
③0.2
④0.3
정답 · 해설 보기
정답 ②
표에서 실제 TRUE·예측 TRUE인 TP는 200, 실제 FALSE인데 TRUE로 예측한 FP는 300, 실제 TRUE인데 FALSE로 예측한 FN은 300입니다. 정밀도는 TP/(TP+FP)=200/500=0.4, 재현율은 TP/(TP+FN)=200/500=0.4입니다. F1은 2×정밀도×재현율/(정밀도+재현율)=2×0.4×0.4/0.8=0.4입니다. 정밀도와 재현율이 같으면 F1도 그 값과 같습니다. 시험 포인트: F1 = 2PR/(P+R), 정밀도와 재현율의 조화평균
문제 20
단원 통계 분석
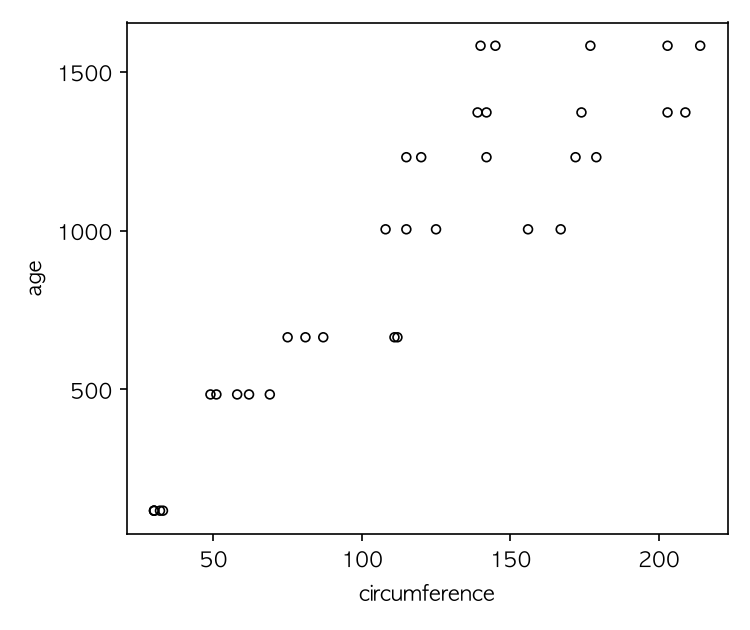
오렌지 데이터에 대한 산점도 관련 설명으로 틀린 것은?
①양의 상관 관계임을 알 수 있다
②Circumference 데이터는 10 ~ 230 정도의 범위 인 것을 알 수 있다
③종별로 관계를 나타낼 수 있다
④Age 데이터는 10 ~ 1600 정도의 범위인 것을 알 수 있다
정답 · 해설 보기
정답 ③
산점도는 가로축 circumference가 약 30~214, 세로축 age가 약 118~1582에 분포하며, 둘레가 클수록 나이가 많아지는 양의 상관관계를 보입니다. 따라서 범위와 양의 상관에 대한 설명은 그래프로 확인할 수 있습니다. 그러나 점이 모두 같은 모양과 색으로 찍혀 있어 나무 종류(Tree)별 구분이 없으므로 종별 관계를 나타낼 수 있다는 설명이 틀렸습니다. 시험 포인트: 산점도로 상관 방향·값 범위 확인, 그룹 구분은 색·기호가 있어야 가능
문제 21
단원 정형 데이터 마이닝
다음 중 K-means 군집의 단점으로 가장 부적절한 것은?
①볼록한 형태가 아닌 군집이 존재하면 성능이 떨어진다
②사전에 주어진 목적이 없으므로 결과 해석이 어렵다
③잡음이나 이상값에 영향을 많이 받는다
④한 번 군집이 형성되면 군집내 객체들은 다른 군집으로 이동할 수 없다
정답 · 해설 보기
정답 ④
K-means는 볼록하지 않은(비구형) 군집을 잘 찾지 못하고, 평균을 쓰므로 잡음과 이상값에 민감하며, 사전 목적이 없어 결과 해석이 어렵다는 단점이 있습니다. 반면 K-means는 반복 과정에서 중심을 다시 계산하며 객체를 가장 가까운 군집에 재배정하므로 한 번 배정된 객체도 다른 군집으로 이동할 수 있습니다. 이동할 수 없는 것은 계층적 군집의 특징입니다. 시험 포인트: K-means = 군집 간 재배정 가능, 계층적 군집 = 한 번 병합되면 이동 불가
문제 22
단원 정형 데이터 마이닝
다음 설명 중 연관 규칙의 단점이 아닌 것은?
①분석 품목 수가 증가하면 분석 계산이 기하급수적으로 증가한다
②너무 세분화된 품목을 가지고 연관규칙을 찾으려면 의미 없는 분석 결과가 도출된다
③품목 간에 구체적으로 어떠한 영향을 주는지 해석하기 어렵다
④상대적 거래량이 적으면 규칙 발견 시 제외되기 쉽다
정답 · 해설 보기
정답 ③
연관규칙 분석은 품목 수가 늘면 계산량이 기하급수적으로 증가하고, 품목을 너무 세분화하면 의미 없는 규칙이 나오며, 거래량이 적은 품목은 규칙 발견에서 제외되기 쉽다는 단점이 있습니다. 반면 결과가 '조건이면 결과'의 if-then 형태로 나와 이해하기 쉽다는 것이 장점입니다. 그래서 해석하기 어렵다는 설명은 연관규칙의 단점이 아닙니다. 시험 포인트: 연관규칙 장점 = 결과 이해 쉬움, 단점 = 계산량 폭증·세분화 문제·적은 거래 품목 제외
문제 23
단원 정형 데이터 마이닝
아래 데이터셋 A, B간의 유사성을 유클리드 거리로 계산하면 얼마인가?
키
몸무게
A
165
65
B
170
70
①50
②25
③$\sqrt{50}$
④10
정답 · 해설 보기
정답 ③
유클리드 거리는 두 점의 각 변수 차이를 제곱해 더한 뒤 제곱근을 취한 값입니다. 키 차이는 170−165=5, 몸무게 차이는 70−65=5이므로 거리는 √(5²+5²)=√(25+25)=√50(약 7.07)입니다. 50은 제곱근을 취하지 않은 값이고, 10은 차이의 절댓값을 더한 맨해튼 거리입니다. 시험 포인트: 유클리드 = √Σ(차이²), 맨해튼 = Σ|차이|
문제 24
단원 통계 분석
스피어만 상관계수에서 사용하는 척도는?
①명목척도
②서열척도
③등간척도
④비율척도
정답 · 해설 보기
정답 ②
스피어만 상관계수는 두 변수의 값을 순위로 바꾸어 순위 간의 상관을 구하는 비모수적 방법으로 서열척도 자료에 사용합니다. 등간척도나 비율척도처럼 연속형 자료의 선형 관계를 볼 때는 피어슨 상관계수를 쓰고, 명목척도는 순서가 없어 순위 상관을 구할 수 없습니다. 시험 포인트: 피어슨 = 등간·비율척도(선형 관계), 스피어만 = 서열척도(순위 상관)
문제 25
단원 정형 데이터 마이닝
SOM은 비지도 신경망으로 고차원의 데이터를 이해하기 쉬운 저차원의 뉴런으로 정렬하여 지도 형태로 형상화 하는 방법이다. 다음 중 SOM 방법에 대한 설명으로 부적절한 것은?
①SOM은 입력변수의 위치 관계를 그대로 보존한다는 특징이 있다. 이러한 SOM의 특징으로 인해 입력 변수의 정보와 그들의 관계가 지도상에 그대로 나타난다
②SOM을 이용한 군집분석은 인공신경망의 역전파 알고리즘을 사용함으로써 수행 속도가 빠르고 군집의 성능이 매우 우수하다
③SOM 알고리즘은 고차원의 데이터를 저차원의 지도 형태로 형상화하기 때문에 시각적으로 이해하기 쉬울 뿐 아니라 변수의 위치 관계를 그대로 보존하기 때문에 실제 데이터가 유사하면 지도상 가깝게 표현된다
④입력층과 2차원의 격자 형태의 경쟁층으로 이루어져 있다
정답 · 해설 보기
정답 ②
SOM(자기조직화지도)은 입력층과 2차원 격자 형태의 경쟁층으로 이루어진 비지도 신경망으로, 입력 변수의 위치 관계를 보존해 유사한 데이터가 지도상 가깝게 표현됩니다. SOM은 역전파 알고리즘이 아니라 승자 독식의 경쟁 학습을 사용하며, 전방 패스만 사용하므로 속도가 빠릅니다. 그래서 역전파 알고리즘을 사용한다는 설명이 틀렸습니다. 시험 포인트: SOM = 경쟁 학습(역전파 X), 입력층 + 2차원 경쟁층, 위치 관계 보존
문제 26
단원 정형 데이터 마이닝
과대적합에 대한 설명으로 가장 부적절한 것은?
①생성된 모델이 훈련 데이터에 너무 최적화되어 학습하여 테스트데이터의 작은 변화에 민감하게 반응하는 경우는 발생하지 않는다
②학습데이터가 모집단의 특성을 충분히 설명하지 못할 때 자주 발생한다
③변수가 너무 많아 모형이 복잡할 때 생긴다
④과대적합이 발생할 것으로 예상되면 학습을 빠르게 종료하는 방법으로 과대적합을 방지할 수 있다
정답 · 해설 보기
정답 ①
과대적합은 모델이 훈련 데이터에 지나치게 맞춰져 훈련 성능은 높지만 새로운 데이터에서는 성능이 떨어지는 현상으로, 데이터의 작은 변화에도 민감하게 반응합니다. 학습 데이터가 모집단 특성을 충분히 담지 못하거나 변수가 많아 모형이 복잡할 때 생기며, 학습 조기 종료로 방지할 수 있습니다. 그래서 작은 변화에 민감하게 반응하는 경우가 발생하지 않는다는 설명이 틀렸습니다. 시험 포인트: 과대적합 = 훈련 데이터에 과최적화, 방지 = 조기 종료·변수 축소·규제
문제 27
단원 정형 데이터 마이닝
아래는 피자와 햄버거의 거래 관계를 나타낸 표로, Pizza/Hamburgers는 피자/햄버거를 포함한 거래수를 의미하고, (Pizza)/(Hamburgers)는 피자/햄버거를 포함하지 않은 거래 수를 의미한다. 아래 표에서 피자구매에 대해 설명한 것으로 가장 적절한 것은 무엇인가?
Pizza
(Pizza)
합계
Hamburgers
2000
500
2500
(Hamburgers)
1000
1500
2500
합계
3000
2000
5000
①지지도가 0.6으로 전체 구매 중 햄버거와 피자가 같이 구매되는 경향이 높다
②정확도가 0.8로 햄버거와 피자의 구매 관련성은 높다
③향상도가 1보다 크므로 햄버거와 피자는 연관성이 매우 높다.
④연관규칙 중 “햄버거 -> 피자” 보다 “피자 -> 햄버거”의 신뢰도가 더 높다
정답 · 해설 보기
정답 ③
피자와 햄버거를 함께 산 거래는 2000건이므로 지지도는 2000/5000=0.4입니다. 신뢰도는 햄버거→피자가 2000/2500=0.8, 피자→햄버거가 2000/3000≈0.67로 햄버거→피자가 더 높습니다. 향상도는 0.4/(0.6×0.5)≈1.33으로 1보다 크므로 양의 연관성이 있습니다. 지지도 0.6은 계산이 틀렸고, 0.8은 정확도가 아니라 신뢰도입니다. 시험 포인트: 지지도 = P(A∩B), 신뢰도 = P(A∩B)/P(A), 향상도 = P(A∩B)/(P(A)P(B))
문제 28
단원 정형 데이터 마이닝
앙상블모형(Ensemble)이란 주어진 자료로부터 여러 개의 예측 모형을 만든 후 이러한 예측 모형들을 결합하여 하나의 최종 예측 모형을 만드는 방법을 말한다. 다음 중 앙상블 모형에 대한 설명으로 적절하지 않은 것은?
①배깅은 주어진 자료에서 여러 개의 붓스트랩(Bootstrap) 자료를 생성하고 각 붓스트랩 자료에 예측 모형을 만든 후 결합하여 최종 모형을 만드는 방법이다
②부스팅은 배깅의 과정과 유사하여 재표본 과정에서 각 자료에 동일한 확률을 부여하여 여러 모형을 만들어 결합하는 방법이다
③랜덤 포레스트(Random Forest)는 의사결정나무모형의 특징인 분산이 크다는 점을 고려하여 배깅보다 더 많은 무작위성을 추가한 방법으로 약한 학습기들을 생성하고 이를 선형 결합해 최종 학습기를 만드는 방법이다
④앙상블 모형은 훈련을 한 뒤 예측을 하는데 사용하므로 교사학습법(Supervised Learning) 이다
정답 · 해설 보기
정답 ②
앙상블은 여러 예측 모형을 결합하는 지도 학습 방법입니다. 배깅은 붓스트랩 자료마다 모형을 만들어 결합하고, 랜덤 포레스트는 배깅에 변수 무작위 선택을 더해 분산을 줄입니다. 부스팅은 재표본 과정에서 모든 자료에 같은 확률을 주는 것이 아니라 잘못 분류된 자료에 더 큰 가중치를 주어 다음 모형을 학습합니다. 그래서 동일한 확률을 부여한다는 설명이 틀렸습니다. 시험 포인트: 배깅 = 동일 확률 붓스트랩, 부스팅 = 오분류 자료에 가중치
문제 29
단원 통계 분석
정규분포 신뢰수준 95%일 때 에 대한 설명으로 가장 적절하지 않는 것은?
①표본크기가 커질수록 신뢰구간이 좁아진다. 이는 정보가 많을수록 추정량이 더 정밀하다는 것을 의미한다
②99% 신뢰수준에 대한 신뢰구간이 95% 신뢰수준에 대한 신뢰구간보다 길다
③신뢰수준은 모수값이 정해져 있을 때 다수 신뢰구간 중 모수값을 포함하는 신뢰구간이 존재할 확률을 말한다
④신뢰수준 95% 의미는 추정값이 신뢰구간에 존재할 확률이 95%라 할 수 있다
정답 · 해설 보기
정답 ④
신뢰수준 95%란 같은 방법으로 표본을 여러 번 뽑아 신뢰구간을 만들면 그중 약 95%가 모수를 포함한다는 뜻입니다. 모수는 고정된 값이고 추정값은 신뢰구간의 중심이므로, 추정값이 신뢰구간에 있을 확률이 95%라는 해석은 틀렸습니다. 표본이 클수록 구간이 좁아지고, 신뢰수준이 높을수록 구간이 길어진다는 설명은 옳습니다. 시험 포인트: 신뢰수준 = 구간들이 모수를 포함하는 비율, 표본 클수록 좁고 신뢰수준 높을수록 넓음
문제 30
단원 통계 분석
회귀방정식의 변수선택 방법에 대한 설명으로 적절하지 않는 것은?
①전진선택법은 변수를 추가해도 영향을 받지 않는다
②후진제거법은 독립변수 후보 모두를 포함한 모형에서 시작한다
③단계별 선택법은 기준 통계치에 가장 도움이 되지 않는 변수를 삭제하거나, 모델에서 빠져 있는 변수 중에서 기준 통계치를 가장 개선 시키는 변수를 추가한다
④회귀모델에서 변수 선택을 위한 판단 기준에는 Cp, AIC, BIC 등이 있으며 값이 작을수록 좋다
정답 · 해설 보기
정답 ①
후진제거법은 모든 후보 변수를 넣은 모형에서 시작해 하나씩 제거하고, 단계별 선택법은 변수 추가와 제거를 함께 검토합니다. 판단 기준인 Cp, AIC, BIC는 작을수록 좋습니다. 전진선택법은 한 번 들어간 변수를 제거하지 않지만, 새 변수가 추가되면 기존 변수의 유의성이 달라질 수 있고 작은 변동에도 결과가 크게 바뀌어 안정성이 부족합니다. 그래서 영향을 받지 않는다는 설명이 틀렸습니다. 시험 포인트: 전진선택 = 추가만(불안정), 후진제거 = 전체에서 제거, 단계별 = 추가·제거 병행
> summary(data_1) Importance of components: PC1 PC2 PC3 PC4 Standard deviation 1.4154 1.3087 0.43779 0.3040 Proportion of Variance 0.5008 0.4281 0.04791 0.0231 Cumulative Proportion 0.5008 0.9290 0.97690 1.0000
①제 3변수까지 사용하면 97.69%의 누적 비율을 갖게 된다.
②제 2변수는 42.81%의 분산 비율을 갖는다
③변수들의 scale이 많이 다른 경우 특정 변수가 전체적인 경향을 좌우하기 때문에 상관계수 행렬을 사용하여 분석하는 것이 좋다.
④PC2의 로딩벡터는 모두 양의 방향을 가지고 있다
정답 · 해설 보기
정답 ④
summary 결과에서 PC2의 분산 비율은 0.4281(42.81%)이고, PC3까지의 누적 비율은 0.9769(97.69%)입니다. scale=TRUE처럼 변수 척도가 크게 다를 때는 상관계수 행렬을 사용하는 것이 좋습니다. 그러나 Rotation에서 PC2의 로딩은 x1이 −0.69, x2가 −0.54로 음수이고 x3, x4만 양수이므로 모두 양의 방향이라는 설명이 틀렸습니다. 시험 포인트: Proportion of Variance = 분산 비율, Cumulative Proportion = 누적 비율, Rotation = 로딩
문제 32
단원 통계 분석
표본추출시 발생하는 오차에 관한 설명 중 잘못된 설명은?
①표본 오차(Sampling Error)는 모집단의 일부인 표본에서 얻은 자료를 통해 모집단 전체의 특성을 추론함으로써 생기는 오차를 의미한다
②비표본 오차(non-sampling error)는 표본크기가 증가함에 따라 증가한다
③표본 편의(Sampling Bias)는 표본추출방법에서 기인하는 오차를 의미하고, 표본 추출 방법에 의해 최소화하거나 없앨 수 있다
④표본 오차는 표본의 크기를 증가시키고, 표본 선택 방법을 엄격히 하여 줄일 수 있다
정답 · 해설 보기
정답 ③
표본오차는 모집단의 일부인 표본으로 전체를 추론해서 생기는 오차로 표본 크기를 늘려 줄일 수 있고, 비표본오차는 조사·응답 과정의 실수로 생기며 표본이 커질수록 오히려 커질 수 있습니다. 표본편의는 표본추출 방법에서 기인하는 편향으로, 확률화(randomization)를 통해 최소화하거나 없앨 수 있다는 점이 교재 서술입니다. 다만 표본추출 방법 개선도 확률화를 뜻한다고 읽으면 옳은 설명으로 볼 여지가 있어 논란이 있습니다. 시험 포인트: 표본편의 = 확률화로 최소화, 비표본오차 = 표본 클수록 증가
문제 33
단원 통계 분석
양성 나온 사람 중에 실제 질병이 있는 사람의 확률은 무엇인가? 이때, 양성인 사람은 0.2, 실제 질병이 있는 사람은 0.1, 검사 결과 양성인 사람은 0.9 이다
①0.09
②0.45
③0.18
④0.5
정답 · 해설 보기
정답 ②
베이즈 정리로 양성 판정을 받은 사람 중 실제 질병이 있을 확률을 구합니다. P(질병|양성)=P(양성|질병)×P(질병)/P(양성)이며, 질병이 있을 때 양성일 확률 0.9, 질병 확률 0.1, 양성 확률 0.2를 넣으면 0.9×0.1/0.2=0.09/0.2=0.45입니다. 0.09는 분모로 나누지 않은 결합확률이고, 0.18이나 0.5는 계산 과정과 맞지 않습니다. 시험 포인트: 베이즈 정리 P(A|B)=P(B|A)P(A)/P(B)
문제 34
단원 정형 데이터 마이닝
다음 표를 사용한 재현율에 관련된 설명으로 틀린 것은?
Actual \ Predict
FALSE
TRUE
FALSE
30
70
TRUE
10
40
①재현율(Recall)을 민감도(Sensitivity)라고도 한다
②재현율은 3/10 이다
③재현율은 TP/(TP+FN) 이다
④재현율과 정밀도(Precision)을 사용해 F1Score를 구한다
정답 · 해설 보기
정답 ②
재현율은 실제 TRUE인 것 중 TRUE로 예측한 비율 TP/(TP+FN)이며 민감도라고도 하고, 정밀도와 함께 F1 점수를 구하는 데 쓰입니다. 표에서 실제 TRUE 행은 예측 FALSE 10, 예측 TRUE 40이므로 TP=40, FN=10이고 재현율은 40/50=0.8입니다. 그래서 재현율이 3/10이라는 설명이 틀렸습니다. 3/10은 실제 FALSE 중 FALSE로 맞힌 특이도입니다. 시험 포인트: 재현율 = TP/(TP+FN) = 민감도, 특이도 = TN/(TN+FP)
문제 35
단원 시계열·차원 축소
주성분 분석에 대한 설명 중 올바른 것은?
①독립변수들과 주성분과의 거리인 '정보손실량'을 최대화하거나 분산을 최소화 한다
②상관관계가 있는 변수들을 선형 결합에 의해 상관관계가 있는 새로운 변수(주성분)를 만들고 분산을 최소화하는 변수로 축약한다
③여러 개의 양적변수(Quantitative variable)들 사이의 분산-공분산 관계를 이용하여 변수들의 선형결합(linear combination)으로 표현하는 기법이다
④정규화 전후의 주성분 결과는 동일하다
정답 · 해설 보기
정답 ③
주성분 분석은 여러 양적 변수 사이의 분산-공분산(또는 상관) 관계를 이용해 변수들의 선형결합으로 주성분을 만드는 차원 축소 기법입니다. 주성분끼리는 서로 상관이 없도록 만들고, 정보 손실을 최소화하며 분산을 최대화하는 방향으로 찾습니다. 정규화 여부에 따라 분산 크기가 달라지므로 정규화 전후 결과도 달라집니다. 시험 포인트: PCA = 선형결합, 주성분 간 무상관, 분산 최대화(정보 손실 최소화)
문제 36
단원 시계열·차원 축소
주성분 분석에서 주성분 수를 선택할 때 고려하지 않아도 되는 것은?
①Scree Plot
②개별 고윳값의 분해 가능 여부
③성분들이 설명하는 분산의 비율
④고윳값(Eigenvalue)
정답 · 해설 보기
정답 ②
주성분 수를 정할 때는 누적 설명 분산 비율(보통 70~90%), 고윳값 크기(상관행렬 기준 1 이상), 스크리 플롯에서 기울기가 완만해지는 지점(엘보우)을 고려합니다. 개별 고윳값의 분해 가능 여부는 주성분 수를 고르는 기준과 관계가 없습니다. 시험 포인트: 주성분 수 선택 = 누적 분산 비율·고윳값·Scree Plot
문제 37
단원 시계열·차원 축소
분해 시계열 분석에 대한 설명 중 옳지 않은 것은?
①시계열에 영향을 주는 일반적인 요인을 시계열에서 분리해 분석하는 방법이다
②추세요인은 자료의 그림을 그렸을 때 그 형태가 오르거나 내리는 등 자료가 어떤 특정한 형태를 취할 때이다
③계절요인은 고정된 주기에 따라 자료가 변화하는 경우이다
④이동평균법은 최근 관측치에 더 높은 가중치를 부여하여 이동 평균을 계산하는 방법이다
정답 · 해설 보기
정답 ④
분해 시계열은 시계열에 영향을 주는 추세요인, 계절요인, 순환요인, 불규칙요인을 분리해 분석하는 방법입니다. 추세요인은 오르거나 내리는 특정 형태, 계절요인은 고정된 주기의 변화입니다. 이동평균법은 최근 일정 기간의 관측치를 같은 가중치로 평균하는 방법이고, 최근 관측치에 더 큰 가중치를 주는 것은 지수평활법입니다. 그래서 이동평균법 설명이 틀렸습니다. 시험 포인트: 이동평균 = 동일 가중치, 지수평활 = 최근 관측치에 큰 가중치
문제 38
단원 정형 데이터 마이닝
의사결정나무모형에 관한 내용으로 적절하지 않은 것은?
①의사결정나무의 목적은 새로운 데이터를 분류(classification)하거나 해당 범주의 값을 예측(Prediction)하는 것이다
②목표변수 유형에 따라 범주형 분류나무(Classification Tree)와 연속형 회귀나무(Regression Tree)로 분류된다
③분리 변수의 P차원 공간에 대한 현재 분할은 이전 분할에 영향을 받지 않는다
④부모마디보다 자식마디의 순수도가 증가하도록 분류나무를 형성해 나간다.
정답 · 해설 보기
정답 ③
의사결정나무는 새로운 데이터의 분류나 값 예측을 목적으로 하며, 목표변수가 범주형이면 분류나무, 연속형이면 회귀나무입니다. 부모마디보다 자식마디의 순수도가 높아지도록 분할합니다. 나무는 위에서부터 차례로 분할하므로 현재 분할은 이전 분할의 결과 위에서 이루어져 그 영향을 받습니다. 그래서 이전 분할에 영향을 받지 않는다는 설명이 틀렸습니다. 시험 포인트: 의사결정나무 = 순차적 분할(이전 분할에 의존), 자식마디 순수도 증가
문제 39
단원 통계 분석
다음 회귀분석에 결과에 대한 설명으로 틀린 것은 무엇인가?
Call: lm(formula = wage ~ age + jobclass, data = df)
Residuals: Min 1Q Median 3Q Max -107.234 -24.751 -6.311 16.308 197.278
Residual standard error: 40.16 on 2997 degrees of freedom Multiple R-squared: 0.07435, Adjusted R-squared: 0.07373 F-statistic: 120.4 on 2 and 2997 DF, p-value: < 2.2e-16
①age 변수는 wage에 대해 유의하지 않다
②종속변수는 wage 이다
③jobclass는 범주형 변수이다
④데이터 개수가 3000개 이다
정답 · 해설 보기
정답 ①
lm(wage ~ age + jobclass) 결과에서 종속변수는 wage입니다. jobclass2. Information처럼 범주 이름이 붙은 계수는 범주형 변수가 더미로 들어갔다는 뜻입니다. 잔차 자유도 2997에 추정한 계수 3개를 더하면 데이터는 3000개입니다. age의 p-value는 2e-16보다 작아 유의수준 0.05에서 매우 유의하므로 age가 유의하지 않다는 설명이 틀렸습니다. 시험 포인트: p-value < 0.05면 유의, n = 잔차 자유도 + 추정 계수 수
문제 40
단원 R·데이터 전처리
다음 Orange 나무에 대한 나이 및 둘레에 대한 분석 결과로 옳지 않은 것은?
> summary(Orange) Tree age circumference 3:7 Min. : 118.0 Min. : 30.0 1:7 1st Qu.: 484.0 1st Qu.: 65.5 5:7 Median :1004.0 Median :115.0 2:7 Mean : 922.1 Mean :115.9 4:7 3rd Qu.:1372.0 3rd Qu.:161.5 Max. :1582.0 Max. :214.0
①circumference의 Median은 115이다
②나무 age와 circumference가 유의한 관계를 가진다.
③age의 IQR은 888이다
④Tree의 종류는 5가지이며 각 종류당 7개의 sample이 존재한다
정답 · 해설 보기
정답 ②
summary(Orange)에서 circumference의 Median은 115이고, age의 IQR은 3사분위 1372에서 1사분위 484를 뺀 888입니다. Tree는 5개 수준이 각각 7개씩 있습니다. 그러나 summary는 변수별 요약 통계만 보여 줄 뿐이므로 age와 circumference가 유의한 관계인지는 상관분석이나 회귀분석을 해야 판단할 수 있습니다. 시험 포인트: IQR = Q3 − Q1, 유의성은 summary가 아니라 검정으로 판단
문제 45
단원 정형 데이터 마이닝
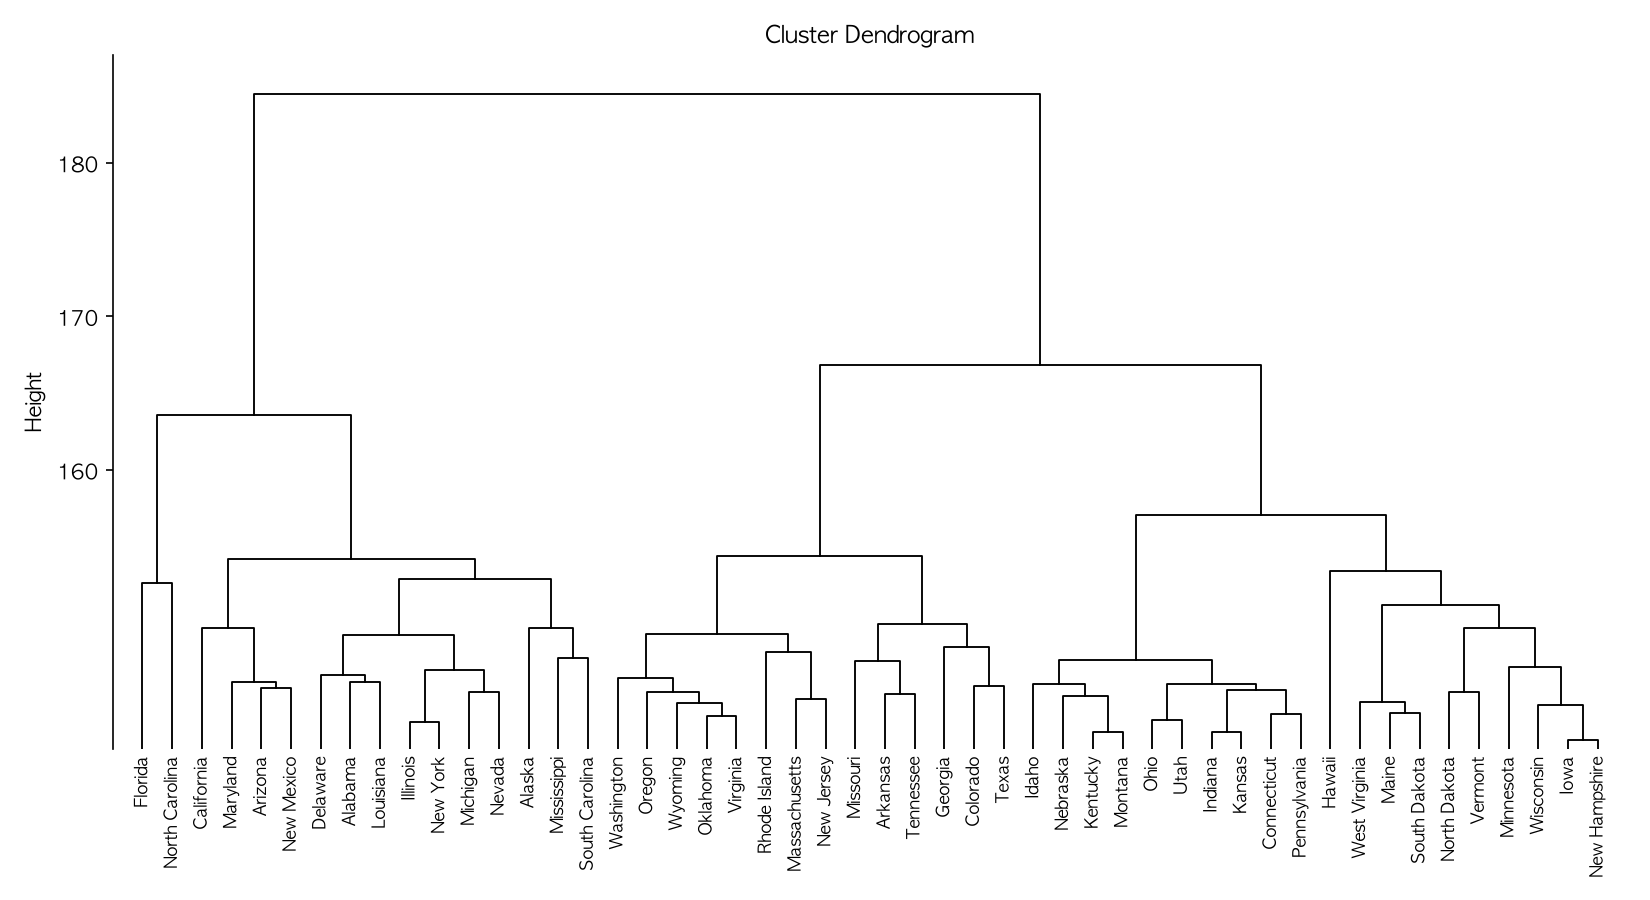
다음 덴드로그램에서 height가 160일 때의 군집 개수는? (숫자 하나만 입력하세요)
정답 · 해설 보기
정답 4 (단답형)
정답은 4입니다. 덴드로그램에서 특정 높이에 수평선을 그었을 때 만나는 세로선의 개수가 군집 수입니다. height 160에서는 왼쪽 무리가 약 163에서 합쳐지기 전이라 Florida·North Carolina 묶음과 나머지 묶음으로 2개, 오른쪽 무리는 약 167에서 합쳐지기 전이라 가운데 묶음과 Idaho부터 New Hampshire까지의 묶음으로 2개가 되어 모두 4개입니다. 시험 포인트: 덴드로그램 군집 수 = 기준 높이의 수평선이 자르는 세로선 수
문제 46
단원 통계 분석
귀무가설이 실제로 사실이어서 채택하여야 함에도 불구하고 이를 기각하는 오류를 무엇이라 하는가?
정답 · 해설 보기
정답 제1종 오류 (단답형)
정답은 제1종 오류입니다. 제1종 오류는 귀무가설이 참인데 이를 기각하는 오류이고, 그 최대 허용 확률이 유의수준(α)입니다. 반대로 귀무가설이 거짓인데 기각하지 못하고 채택하는 오류는 제2종 오류(β)이며, 1−β는 대립가설이 참일 때 올바르게 귀무가설을 기각할 확률인 검정력입니다. 시험 포인트: 제1종 오류 = 참인 H0 기각(α), 제2종 오류 = 거짓인 H0 채택(β)
문제 47
단원 R·데이터 전처리
신경망 모형에서 표준화 지수함수로 불리며, 출력 값 z가 여러 개로 주어지고, 목표치가 다 범주인 경우 각 범주에 속할 사후확률을 제공하여 출력 노드에 주로 사용되는 함수는 무엇인가?
정답 · 해설 보기
정답 softmax (단답형)
정답은 softmax(소프트맥스) 함수입니다. softmax는 여러 출력값 z를 지수함수로 변환한 뒤 전체 합으로 나누어 표준화하므로 출력의 합이 1이 되고, 각 범주에 속할 사후확률로 해석할 수 있어 다범주 분류의 출력 노드에 주로 씁니다. 시그모이드는 0과 1 사이 값 하나를 내 이진 분류에 쓰이고, ReLU는 주로 은닉층에 쓰인다는 점이 다릅니다. 시험 포인트: softmax = 다범주 출력(합 1), sigmoid = 이진 분류
문제 48
단원 정형 데이터 마이닝
오분류표 용어 중 실제로 False일 때 예측이 적중하는 경우를 무엇이라고 하는가?
정답 · 해설 보기
정답 특이도 (단답형)
정답은 특이도(Specificity)입니다. 특이도는 실제 False인 것 중 False로 올바르게 예측한 비율로 TN/(TN+FP)입니다. 실제 True 중 True로 맞힌 비율은 민감도(재현율) TP/(TP+FN)이고, 예측 True 중 실제 True의 비율은 정밀도입니다. 발문이 비율이 아니라 경우를 묻고 있어 TN(True Negative)으로 읽힐 여지가 있지만, 시행처 정답은 특이도입니다. 시험 포인트: 특이도 = TN/(TN+FP), 민감도 = TP/(TP+FN)
문제 49
단원 정형 데이터 마이닝
은닉층이 다층인 신경망을 학습하다 보면 역전파 과정에서 초기 부분의 입력층으로 갈수록 기울기 변화가 점차적으로 작아지는 현상은?
정답 · 해설 보기
정답 기울기 소실 (단답형)
정답은 기울기 소실(Vanishing Gradient)입니다. 은닉층이 많은 신경망에서 역전파로 기울기를 전달할 때, 시그모이드처럼 미분값이 작은 활성화 함수를 거듭 곱하면서 입력층에 가까울수록 기울기가 0에 가까워져 가중치가 거의 갱신되지 않는 현상입니다. ReLU 같은 활성화 함수로 완화할 수 있습니다. 반대로 기울기가 지나치게 커지는 현상은 기울기 폭발입니다. 시험 포인트: 기울기 소실 = 입력층 쪽 기울기 0에 수렴, ReLU로 완화
문제 50
단원 정형 데이터 마이닝
로지스틱 회귀모형에서 exp(x1)의 의미는 나머지 변수가 주어질 때 x1이 한 단위 증가할 때마다. 성공(Y=1)의 ( )가 몇 배 증가 하는지를 나타낸다. ( )에 들어가는 용어는?
정답 · 해설 보기
정답 오즈 (단답형)
정답은 오즈(odds)입니다. 오즈는 성공 확률을 실패 확률로 나눈 p/(1−p)이며, 로지스틱 회귀는 오즈의 로그값을 설명변수의 선형식으로 나타냅니다. 따라서 x1의 계수가 β1이면 다른 변수가 같을 때 x1이 한 단위 증가할 때마다 오즈가 exp(β1)배 변합니다. 확률 p 자체가 일정한 배수로 늘어나는 것이 아니라는 점에서 확률과 오즈를 구별해야 합니다. 시험 포인트: 오즈 = p/(1−p), exp(계수) = 오즈비(한 단위 증가 시 오즈의 배수)